Engenharia de Loop: Como Construir Agentes que Melhoram o Próprio Trabalho

Da criação manual de prompts à engenharia de loop

A maioria das pessoas ainda opera agentes de IA manualmente.

Elas inserem uma tarefa, aguardam uma resposta, revisam o resultado, corrigem os erros, e então enviam outro prompt.

O ser humano ainda é quem executa o loop.

A próxima etapa é diferente.

Você deixa de fazer o prompting do agente passo a passo e passa a construir um loop ao redor dele.

O loop fornece as instruções, verifica o resultado, escolhe a próxima ação e continua executando até que o resultado atenda ao padrão estabelecido.

Isso é engenharia de loop.

A ideia é simples:

Pare de gastar seu tempo criando prompts manualmente para os agentes.

Comece a projetar sistemas que criem esses prompts para você.

“Você não deveria mais ficar criando prompts para agentes de programação. Você deveria projetar loops que criem prompts para seus agentes.”

Boris Cherny lidera o Claude Code na Anthropic.

Ele descreveu essa mesma mudança a partir de seu próprio fluxo de trabalho:

“Eu não crio mais prompts para o Claude. Tenho loops que executam prompts para o Claude e descobrem o que fazer. Meu trabalho é escrever loops.”

Por que a maioria das pessoas ainda não constrói loops de verdade

Os loops parecem incríveis até você ver a conta de tokens.

Um loop de agente normal pode consumir contexto extremamente rápido:

  • Um loop de programação de tamanho médio pode usar 50 mil a 200 mil tokens.
  • Uma frota com um orquestrador e agentes especialistas pode usar 500 mil a 2 milhões de tokens.
  • Um loop programado para ser executado diariamente pode consumir milhões de tokens por semana.

Cada nova tentativa custa tokens. Cada correção custa tokens. Cada etapa de verificação custa tokens. Cada subagente acrescenta uma nova cobrança.

Essa é a limitação oculta que raramente é discutida.

A engenharia de loop não é difícil porque o conceito seja complicado de entender.

Ela é difícil porque a maioria dos usuários não pode pagar por execuções ilimitadas de agentes.

A resposta óbvia é:

“É fácil para você dizer isso, você tem acesso ilimitado à OpenAI.”

E essa crítica é justa.

É por isso que modelos baratos com grandes janelas de contexto são tão importantes.

Para executar loops úteis todos os dias, você precisa de:

  • Tokens de entrada acessíveis
  • Tokens de saída acessíveis
  • Grandes janelas de contexto
  • Chamadas de ferramentas confiáveis
  • Saída estruturada em JSON
  • Alta concorrência
  • Contexto suficiente para lembrar das etapas anteriores

Sem essas características, os loops continuam sendo experimentos caros.

Com elas, os loops se tornam sistemas práticos capazes de executar trabalho real.

O fluxo de trabalho antigo versus o novo

Nos últimos dois anos, a maioria das pessoas utilizou agentes desta forma:

Você cria um prompt. O agente responde. Você revisa a resposta. Percebe um problema. Cria outro prompt.

Funciona, mas não escala.

O fluxo de trabalho antigo

  • Você escreve o prompt
  • O agente cria uma saída
  • Você inspeciona a saída
  • Você corrige os pontos fracos
  • Você repete manualmente o processo

O novo fluxo de trabalho

  • Você define o resultado desejado
  • O loop descobre o que é necessário
  • O loop cria um plano
  • O agente executa o trabalho
  • Um verificador avalia o resultado
  • O loop corrige as falhas
  • O sistema para quando o objetivo é concluído

Um prompt fornece ao agente uma única instrução.

Um loop fornece ao agente um trabalho completo.

O que realmente significa engenharia de loop

Engenharia de loop significa construir ciclos de feedback repetíveis ao redor de agentes de IA.

O objetivo é simples:

Passar de uma primeira tentativa para um resultado verificado, sem que um ser humano controle cada etapa.

O loop básico contém cinco etapas:

  1. Descobrir
  2. Planejar
  3. Executar
  4. Verificar
  5. Iterar

Se o resultado passar pela verificação, entregue-o.

Se o resultado falhar, devolva-o ao loop.

Esse é todo o conceito.

Você não está tentando escrever um prompt perfeito.

Você está criando um sistema que melhora resultados imperfeitos até que eles atendam ao requisito.

Loop de agente único

Os loop geralmente aparecem em dois tamanhos.

A versão menor usa um único agente para completar todo o ciclo.

Ele descobre o que precisa acontecer, planeja o trabalho, executa a tarefa, revisa o resultado e tenta novamente quando algo falha.

É semelhante a uma pessoa editando seu próprio rascunho até que ele esteja pronto.

Loop de agente único funcionam bem para:

  • Tarefas específicas
  • Escopos limitados
  • Objetivos claros
  • Rascunhos de conteúdo
  • Correções de bugs
  • Resumos de pesquisas

Um agente. Um ciclo de feedback. Melhoria contínua por conta própria.

Loop em frota

Um loop em frota opera em uma escala maior.

Um orquestrador recebe o objetivo principal.

Ele divide o objetivo em partes menores.

Essas partes são atribuídas a agentes especialistas.

Cada especialista também pode delegar tarefas específicas a subagentes menores.

Exemplo

Objetivo: Construir um aplicativo de produtividade

 Orquestrador
                  /    |    \
                 /     |     \
          Pesquisa  Engenharia   QA
          Especialista Especialista Especialista
              |          |           |
        Pesquisador   Escritor de   Escritor de
          Web           Código        Testes
                           +            +
                        Debugger    Rastreador
                                      de Bugs 

Isso já não é mais um único agente trabalhando sozinho.

É mais parecido com uma pequena equipe autônoma executando um projeto do início ao fim.

Loops abertos versus loops fechados

Essa é a diferença prática mais importante.

Nem todo loop funciona da mesma maneira.

Loops abertos

Loops abertos são exploratórios.

Você fornece um objetivo amplo e permite que o agente descubra seu próprio caminho.

O agente pode descobrir coisas úteis que você nunca especificou.

Mas também pode se tornar caro e caótico.

Loops abertos podem:

  • Explorar direções demais
  • Desperdiçar grandes quantidades de tokens
  • Gerar trabalho de baixa qualidade em alta velocidade
  • Se afastar do objetivo real
  • Tornar-se difíceis de controlar

Loops abertos são empolgantes.

Mas geralmente não são o melhor ponto de partida.

Loops fechados

Loops fechados possuem limites claros.

O ser humano define o caminho primeiro.

O loop ainda opera de forma independente, mas permanece dentro de regras explícitas.

Um loop fechado inclui:

  • Um objetivo claro
  • Etapas definidas
  • Avaliação após cada etapa
  • Uma condição de parada
  • Transferência para um ser humano caso o sistema fique bloqueado

Essa é a versão que gera valor hoje.

Ela custa menos. É mais fácil de confiar. Produz resultados mais consistentes.

Comece com loops fechados.

Torne-os mais abertos somente depois que seus mecanismos de verificação forem suficientemente robustos.

Os 6 blocos de construção de um loop eficaz

Todo loop segue conceitualmente o mesmo ciclo de cinco etapas.

Na prática, seis blocos de construção tornam esse ciclo realmente útil.

1. Automações

A automação é o coração do loop.

Ela inicia o processo sem exigir que você se lembre de iniciá-lo manualmente.

Exemplos:

  • Executar todas as manhãs
  • Executar sempre que um PR for aberto
  • Executar depois que um arquivo for alterado
  • Executar quando um novo ticket aparecer
  • Continuar até que todos os testes sejam aprovados

Se você ainda precisa iniciar cada ação manualmente, o loop não está fazendo o suficiente.

2. Worktrees

Worktrees tornam-se importantes quando vários agentes editam código simultaneamente.

Sem isolamento, os agentes entram em conflito.

Dois agentes podem alterar o mesmo arquivo.

Um agente pode sobrescrever o trabalho de outro.

Um worktree fornece a cada agente um espaço de trabalho e uma branch separados.

Isso permite que vários agentes trabalhem em paralelo sem transformar o repositório em uma bagunça.

3. Skills

Skills armazenam conhecimento reutilizável sobre o projeto.

Pare de explicar o mesmo contexto a cada execução.

Escreva as informações importantes uma única vez.

Permita que todos os loops futuros as reutilizem.

Arquivos de skills úteis podem conter:

  • Visão do produto
  • Arquitetura
  • Regras do projeto
  • Instruções de compilação
  • Instruções de testes
  • Ações que o agente nunca deve executar

Sem skills, cada loop começa do zero.

Com skills, cada execução começa com o conhecimento acumulado dos trabalhos anteriores.

4. Plugins e conectores

Um loop que só consegue ler arquivos locais tem valor limitado.

Conectores permitem que ele interaja com as ferramentas onde o trabalho real acontece.

Exemplos:

  • GitHub
  • Slack
  • Linear
  • Jira
  • Gmail
  • Google Drive
  • Bancos de dados
  • APIs de staging

Essa é a diferença entre:

“Aqui está uma possível correção.”

e:

“Abri o PR e o conectei ao ticket. Depois monitorei o CI e publiquei a atualização final.”

5. Subagentes

O agente que cria e o agente que verifica nem sempre devem ser o mesmo.

Um agente que escreveu o código pode ser tolerante demais ao revisá-lo.

Um agente que escreveu um artigo pode deixar passar as mesmas seções fracas duas vezes.

Use agentes separados para:

  • Exploração
  • Implementação
  • Revisão
  • Testes
  • Verificação de fatos
  • Resumos finais

A qualidade melhora quando o revisor é independente.

O criador não deve ser o único responsável por verificar o trabalho.

6. Memória

A memória permite que o loop continue entre várias execuções.

O modelo esquece.

O repositório não.

As anotações não.

O registro do projeto não.

A memória pode ser armazenada em:

  • Arquivos Markdown
  • Logs do projeto
  • Tickets do Linear
  • Issues do GitHub
  • Cofres do Obsidian
  • Bancos de dados
  • Claude Projects

Um loop de longa duração precisa lembrar o que já foi tentado.

O que funcionou.

O que falhou.

E o que ainda precisa ser concluído.

Sem memória persistente, o loop começa do zero toda vez.

Exemplos reais de loops

Esses fluxos de trabalho tornam a ideia mais concreta.

Loop de programação

Ler VISION.md + ARCHITECTURE.md
Planejar a próxima alteração
Editar o código
Executar os testes
Se os testes falharem → inspecionar o erro
→ corrigir
→ testar novamente
Se os testes passarem → resumir as alterações
Parar

Um ser humano não precisa conduzir cada etapa.

O agente escreve, testa, corrige e verifica seu próprio trabalho.

Loop de pesquisa

Definir a pergunta de pesquisa
Encontrar fontes relevantes
Resumir as evidências
Verificar cada afirmação em relação às fontes
Comparar informações conflitantes
Criar a síntese final
Parar quando o limite de confiança for atingido

Isso produz um resultado muito mais robusto do que pedir um único resumo rápido.

Loop de conteúdo

Definir tópico + público + objetivo
Criar o primeiro rascunho
Enviar para um agente de crítica
Reescrever usando a crítica
Avaliar segundo os critérios de sucesso
Se passar → publicar
Se falhar → reescrever novamente

O loop transforma uma única ideia em um sistema de conteúdo repetível.

Loop de prospecção de vendas

Definir o ICP
Encontrar leads que correspondam ao perfil
Enriquecer cada lead com dados da empresa
Qualificá-los de acordo com os critérios
Personalizar a mensagem
Executar uma revisão de qualidade
Enviar ou encaminhar para um ser humano

Todos os exemplos utilizam a mesma estrutura:

Objetivo → Ação → Verificação → Correção → Repetição até concluir o trabalho

Engenheiro de prompt versus engenheiro de loop

Essa é a nova lacuna de habilidades que está surgindo em 2026.

Engenheiro de prompt

Um engenheiro de prompt concentra-se em criar instruções melhores.

Ele aprimora a redação.

Produz uma resposta única mais forte.

Mas, depois que o agente termina, um ser humano ainda precisa revisar tudo.

O ser humano continua sendo o loop de feedback.

Engenheiro de loop

Um engenheiro de loop constrói o próprio sistema de feedback.

Ele determina:

  • O que inicia o loop
  • Qual contexto o agente recebe
  • Quais ferramentas ele pode acessar
  • O que é considerado sucesso
  • Quem verifica o resultado
  • Quando o processo deve parar
  • Onde o resultado final é armazenado

Um engenheiro de prompt diz:

“Escreva uma função para mim.”

Um engenheiro de loop diz:

“Escreva a função.” “Teste-a e corrija-a até que todos os testes sejam aprovados.” “Depois, faça um resumo da alteração.”

As ferramentas podem ser idênticas.

A mentalidade é completamente diferente.

Os construtores de IA que geram maior impacto estão indo além de instruções melhores.

Eles estão criando sistemas que descobrem e planejam, executam e verificam, e então param no momento correto.

A versão resumida

Engenharia de loop é a transição de prompts manuais para ciclos automatizados de feedback.

A mudança

  • Forma antiga: Dar ao agente uma tarefa de cada vez
  • Nova forma: Construir um loop que gerencia o ciclo completo

As 6 coisas que você constrói

  • Automações: Iniciam o loop automaticamente
  • Worktrees: Permitem que os agentes trabalhem em paralelo sem conflitos de arquivos
  • Skills: Reutilizam o conhecimento do projeto em cada execução
  • Plugins e conectores: Dão ao loop acesso a ferramentas reais
  • Subagentes: Separam criadores de revisores
  • Memória: Preserva o conhecimento entre as execuções

Os 2 tamanhos

  • Loop de agente único: Um agente melhora repetidamente seu próprio trabalho
  • Loop em frota: Um orquestrador coordena especialistas e subagentes

Os 2 tipos

  • Loop aberto: Flexível, exploratório e caro
  • Loop fechado: Limitado, confiável e acessível

As 5 etapas

  1. Descobrir
  2. Planejar
  3. Executar
  4. Verificar
  5. Iterar

O verdadeiro problema de custo

  • Loops consomem tokens rapidamente
  • Modelos baratos com contexto longo tornam os loops viáveis
  • Sem tokens acessíveis, a maioria dos usuários nunca passa dos experimentos

A mudança de mentalidade

  • Engenheiros de prompts solicitam resultados à IA
  • Engenheiros de loop constroem sistemas que entregam resultados verificados

Esse é o verdadeiro ponto de virada.

Pare de procurar um único prompt perfeito.

Construa um loop que continue tornando melhores os resultados imperfeitos.

Um loop confiável vencerá um prompt perfeito.

Fonte:

Este artigo e a imagem foram traduzidos e adptados do texto original em inglês de @elune0x em https://x.com/elune0x/status/2079923329633313196 e publicado no Linkedin

Vide:

DeepTech – Ciência e Tecnologia a serviço da Inovação e Negócios

Depois de ter empreendido em duas empresas de tecnologia, ao longo dos últimos 12 anos tenho contribuído com o ecossistema brasileiro de startups de diversas formas: participando como convidado em eventos, organizando o livro “Empreendedorismo Inovador: Como criar startups de tecnologia no Brasil”, provendo mentoria e consultoria de negócios para dezenas de startups e empresas, participando de outros livros e postando artigos neste blog.

No recente evento DeepCamp do IPT em parceria com o SEBRAE,  a convite de Luciano Avallone, participei do painel sobre Modelos de Negócio DeepTech, moderado por Tatyane Sales num bate-papo junto com Jorge Pacheco (STATE) e Paula Lima (CIETEC).

No painel conversamos desde Proposição de Valor e outros elementos importantes a serem considerados em um modelo de negócios DeepTech, até questões sobre investimentos, laboratórios, inovação aberta na conexão de startups com empresas, propriedade intelectual (patente), licenciamento/transferência de tecnologia e legalização junto aos órgãos regulamentadores.

Este post é dedicado a cientistas, engenheiros, designers, empreendedores e investidores envolvidos com negócios DeepTech, bem como aos que administram laboratórios científicos/técnicos e incubadoras de empresas.

Image: Particle spin occurs in the subatomic world where the laws of quantum physics apply (*1)

O que é DeepTech?

O termo DeepTech, refere-se às startups cujo modelo de negócios é baseado em inovação de alta tecnologia em engenharia ou avanços científicos significativos. Envolve o aproveitamento de tecnologias maduras e emergentes para resolver os maiores problemas que o mundo enfrenta hoje, ao mesmo tempo em atua com objetivos de negócios arrojados e revigora cadeias de valor.

Deeptechs pesquisam, desenvolvem e implantam tecnologias de grande impacto e alto capital, como inteligência artificial, biologia sintética, computação quântica e realidade aumentada.

As tecnologias emergentes são muito promissoras, mas sem uma maneira de focar a tecnologia certa nos desafios mais urgentes, as empresas não podem obter todo o seu valor.

Vale observar que não existe uma tal “tecnologia profunda”, DeepTech trata-se uma abordagem habilitada pela orientação a problemas e a convergência de abordagens e tecnologias, impulsionada pelo ciclo de design-construção-teste-aprendizagem (DBTL – Design-Build-Test-Learn).

Como observou Clayton Christensen, que desenvolveu a teoria da tecnologia disruptiva, poucas tecnologias são intrinsecamente disruptivas ou sustentáveis em si mesmas; em vez disso, a solução e o modelo de negócios construído em torno ou por meio das tecnologias são disruptivos. A mesma ideia se aplica à DeepTech.

As DeepTechs questionam barreiras básicas, obstáculos e pontos cegos na abordagem atual para a solução de problemas. Elas contam com tecnologias emergentes enraizadas na ciência e engenharia avançada que oferecem avanços significativos em relação às tecnologias estabelecidas. Na verdade, aproximadamente 70% dos empreendimentos DeepTech possuem patentes que cobrem a tecnologia que usam, e geralmente exigem pesquisa e desenvolvimento (P&D) e engenharia significativos antes que as empresas possam trazer soluções práticas de negócios ou de consumo do laboratório para o mercado e usá-las para resolver problemas fundamentais.

Atributos complementares dos empreendimentos DeepTechs

  • São orientados para o problema. Concentram-se em resolver problemas grandes e fundamentais, como fica claro pelo fato de que 97% dos empreendimentos DeepTech contribuem para pelo menos uma das metas de desenvolvimento sustentável da ONU.
  • Atuam na convergência de tecnologias. Por exemplo, 96% dos empreendimentos DeepTech usam pelo menos duas tecnologias e 66% usam mais de uma tecnologia avançada. Cerca de 70% dos empreendimentos de tecnologia profunda possuem patentes em suas tecnologias.
  • Desenvolvem principalmente produtos físicos, em vez de software. De fato, 83% dos empreendimentos DeepTech estão envolvidos na construção de um produto físico. Eles estão mudando a equação da inovação de bits para bits e átomos, trazendo o poder dos dados e da computação para o mundo físico.
  • Estão no centro de um ecossistema DeepTech. Cerca de 1.500 universidades e laboratórios de pesquisa estão envolvidos em DeepTech, e empreendimentos DeepTech receberam cerca de 1.500 doações de governos somente em 2018.

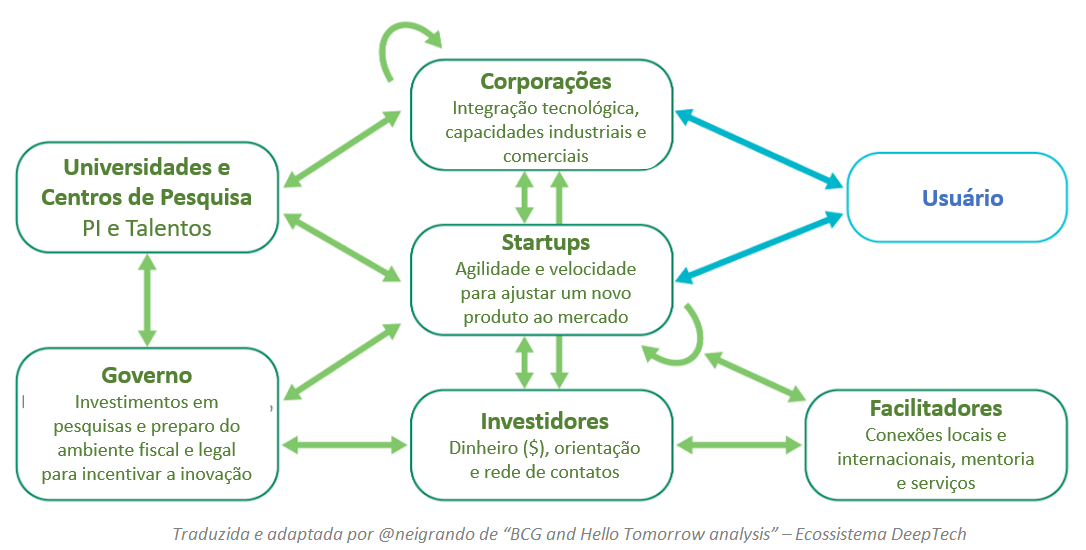
Ecossistema DeepTech

Na imagem que segue pode-se observar que no ecossistema DeepTech cada participante contribuindo com valor.

A Quarta Onda de Inovação

A primeira onda de inovação empresarial moderna começou no século XIX e início do século XX com avanços como o processo Bessemer para fabricação de aço e o processo Haber-Bosch para fabricação de amônia.

Após a Segunda Guerra Mundial, a segunda onda de inovação empresarial moderna – a revolução da informação – deu origem à P&D de grandes empresas, particularmente nos setores de TIC e farmacêutico. Bell Labs, IBM e Xerox PARC tornaram-se nomes conhecidos e oficinas do Prêmio Nobel. Só a Merck lançou sete novos medicamentos importantes durante a década de 1980.

Na onda seguinte, a revolução digital – dois caras em uma garagem (ou um dormitório de Harvard) – liderou a carga de inovação, resultando na ascensão do Vale do Silício e, mais tarde, da Costa Dourada da China como centros globais de tecnologia de computação e comunicação e crescimento econômico. Ao mesmo tempo, o novo campo da biotecnologia, também impulsionado por empreendedores, alimentou grande parte da inovação em produtos farmacêuticos.

A onda agora tomando forma à medida que as barreiras mais antigas à inovação desmoronam abraça um novo modelo e promete ampliar e aprofundar radicalmente a inovação em todos os setores de negócios.

O poder crescente e o custo decrescente da computação e o aumento das plataformas de tecnologia são os contribuintes mais importantes. A computação em nuvem está melhorando constantemente o desempenho e expandindo a amplitude de uso. As biofundições estão se tornando para a biologia sintética o que a computação em nuvem já é para a computação. Plataformas semelhantes estão surgindo em materiais avançados (Kebotix e VSPARTICLE são dois exemplos).

Enquanto isso, os custos continuam caindo, incluindo aqueles relacionados a equipamentos, tecnologia e acesso à infraestrutura.

O uso crescente de padrões, kits de ferramentas e uma abordagem aberta à inovação, juntamente com a disponibilidade cada vez maior de informações e dados, também está desempenhando um papel importante.

Alimentando a Grande Onda: A Abordagem da Deep Tech

Os empreendimentos de tecnologia profunda bem-sucedidos contam com uma abordagem tripla

  • Eles usam a orientação para problemas para identificar oportunidades e navegar e dominar a complexidade.
  • As convergências de abordagens e de tecnologias potencializam a inovação, ampliam o espaço de opções e resolvem problemas para os quais não existiam soluções anteriormente.
  • O ciclo de projeto-construção-teste-aprendizagem (DBTL) reduz os riscos e acelera o desenvolvimento do produto e o tempo de comercialização.

As DeepTechs vivem na convergência de três abordagens

A convergência de tecnologias abre novas oportunidades

Draft de um canvas de Modelo de Negócios DeepTech genérico

Aqui vale lembrar que um modelo de negócios em sua essência deve comunicar de forma sintética como a organização cria, entrega e captura valor. Considera-se que deve acompanhar um plano estratégico bem elaborado, que fará parte de um Plano de Negócios, e que os slides de um pitch devem conter um belo resumo deste plano.

Observação: Cada Negócio DeepTech provavelmente será único, com um modelo de negócios apropriado a ser desenhado de forma apropriada para representá-lo.

Considerações finais

O objetivo deste post foi o de fornecer um resumo introdutório ao tema DeepTech e apresentar uma ideia de sua abrangência. Vide abaixo, links para mais artigos relacionados com empreendedorismo inovador.

Sobre mim: aqui. Contato: aqui.

Abraços, Nei Grando

Referências

Este post foi elaborado a partir de uma tradução adaptada e resumida de um um relatório da consultoria BCG “Deep Tech and the Great Wave of Innovation”, by Antoine Gourevitch, Massimo Portincaso, Arnaud de la Tour, Nicolas Goeldel, and Usman Chaudhry.

Outras referências consideradas neste post:

Links para os sites das instituições mencionadas

Artigos relacionados

A identificação das necessidades do cliente no desenvolvimento de novos produtos

Segundo Bayus (2008), no que diz respeito à inovação e ao Desenvolvimento de Novos Produtos (DNP), a linguagem associada às “necessidades do cliente” difere nas literaturas de marketing, engenharia e design industrial. Diferentes terminologias são frequentemente utilizadas de forma intercambiável: necessidades, desejos, atributos, recursos, requisitos, especificações, etc. As necessidades, ou seja, “o que” é desejado pelos clientes, são dependentes do uso (onde e como o produto é usado), do consumidor (quem usará o produto) e do mercado (quais produtos concorrentes estão disponíveis), enquanto que os atributos, características, requisitos e especificações tratam de “como” uma necessidade é satisfeita por um produto ou serviço específico.

Na literatura econômica, as características do produto, definidas como suas propriedades, relevantes para a escolha do consumidor, são de natureza quantitativa, universais e podem ser medidas objetivamente. Os atributos do produto são mais abstratos e geralmente em menor número do que suas características, sendo baseados nas dimensões perceptivas que os consumidores usam para tomar decisões de compra. Já os requisitos, a partir das literaturas de engenharia e design, são as soluções técnicas e de engenharia que buscam satisfazer as necessidades do cliente, sendo as especificações as métricas específicas associadas aos requisitos. Assim, as características, os atributos, os requisitos e as especificações do produto estão intimamente relacionados e se sobrepõem.

Esta figura resume esta argumentação sobre a linguagem de necessidades do cliente no DNP.

Fonte: Traduzido e adaptado de Bayus (2008)

Conforme Bayus (2008) e Shahrizal (2013), no Fuzzy Front-End (FFE) do processo de inovação, ou seja, no período entre quando uma oportunidade é primeiramente considerada e quando uma ideia é julgada pronta para o desenvolvimento, compreender as necessidades do cliente é uma entrada chave no que se tornou conhecido como Voz do Cliente (VOC). Com base no movimento de gerenciamento de qualidade total, a VOC e o Desdobramento da Função de Qualidade (QFD) permitem que o marketing, design, engenharia, P&D e fabricação se comuniquem efetivamente em limites funcionais. Esta comunicação multifuncional é crucial para assegurar que os esforços de desenvolvimento se concentrem em inovações desejáveis, viáveis e vendáveis. A VOC inclui a identificação de um conjunto de necessidades detalhadas do cliente e as resume em uma hierarquia onde cada necessidade é priorizada em relação à importância do cliente. A VOC é traduzida em requisitos e especificações do produto para o QFD, que por sua vez são traduzidos em atributos de produtos específicos que podem ser agrupados em conceitos e protótipos para testes adicionais com clientes. O modelo Kano de satisfação de cliente é citado como um Método, Técnica ou Ferramenta para Inovação (MTFI) alternativo bastante útil na determinação dos tipos de necessidades dos clientes.

Os designers praticantes, bem como as literaturas de sociologia e antropologia, tendem a enfatizar MTFIs para entender a gama completa de necessidades dos clientes, que incluem: métodos de projeto empáticos, design centrado no usuário, inquérito contextual, abordagens de etnografia e pesquisa de mercado não tradicionais. MTFIs tradicionais de pesquisa de mercado também são usados para buscar entender necessidades articuladas, como: grupo focal e entrevistas pessoais com profundidade; mapeamento perceptual; segmentação; modelagem de preferência; e testes simulados de mercado. Além disso, os pesquisadores sugerem formas de incorporar aspectos estéticos, emocionais e experienciais na identificação das necessidades dos clientes. Outras pesquisas abordam o tema de priorização que incluem o uso de escalas de classificação direta, processo hierárquico analítico, análise conjunta e métodos difusos / entropia.

As literaturas de engenharia, qualidade e operações consideram um novo produto como uma montagem complexa decomponentes interativos para os quais vários modelos paramétricos são construídos para otimizar os objetivos de desempenho. Engenheiros geralmente utilizam a intuição ao lidar com as necessidades dos clientes, enfatizando a criatividade e a funcionalidade do conceito de produto e trabalhando em direção a objetivos técnicos como confiabilidade, durabilidade, impacto ambiental, uso de energia, geração de calor, manufatura, e redução de custos. Dado um conjunto de requisitos de clientes e especificações de produtos e informações relacionadas sobre prioridades, valores ótimos para variáveis de projeto podem ser determinados usando técnicas padrão. O método de cascata de metas analíticas pode ser usado para resolver compromissos técnicos ao reconhecer explicitamente projetos que são caros e / ou impossíveis de alcançar.

Em geral, a literatura de marketing não aborda diretamente a compreensão das necessidades dos clientes, em vez disso, enfoca de forma implícita ou explícita a fase de geração e teste de conceitos no processo de inovação. Para facilitar a comunicação com a engenharia, o marketing costuma considerar um novo produto ou serviço como um conjunto de atributos e características “acionáveis”, algo útil para localizar oportunidades para a melhoria de produtos que podem não ser muito diferentes dos atuais.

Bayus (2008) menciona ainda quatro dimensões “universais” de necessidades do cliente que podem estar associadas a um produto ou serviço:

  • Funcionalidade (desempenho, confiabilidade, compatibilidade, flexibilidade);
  • Forma (estética, durabilidade, portabilidade, capacidade de manutenção, singularidade);
  • Usabilidade (facilidade de uso, complexidade); e
  • Custo (aquisição, uso, disposição).

Esta figura que segue resume estas relações entre ideias, conceitos e disciplinas sobre necessidades do cliente e exemplos de MTFIs.

Fonte:Traduzido e adaptado de Bayus (2008)

Detalhes: aqui, Contato: aqui.

Observação: Este texto foi levemente adaptado do original da minha dissertação de mestrado sobre “Métodos, Técnicas e Ferramentas para Inovação: conhecimento, uso e eficácia em empresas brasileiras”, disponível em: https://teses.usp.br/teses/disponiveis/12/12139/tde-01122017-155036/pt-br.php

Referências:

Bayus, B.L. (2008). Understanding customer needs. Handbook of Technology and Innovation Management, 115-142.

Shahrizal,S. M. (2013). The Use of Design for Six Sigma (DFSS) Methodology in Product Design. In Proceedings of the WorldCongress on.

Tschimmel, K.(2012). Design Thinking as an effective Toolkit for Innovation. In ISPIM Conference Proceedings (p. 1). The International Society for Professional Innovation Management (ISPIM).

Links Relacionados: