Engenharia de Harness: O motor não é mais o problema

Por que a estrutura ao redor do modelo — o “harness” — decide se um agente de IA funciona de verdade

Durante um bom tempo, o jogo foi aprender a se comunicar melhor com o modelo. Depois, o jogo virou garantir que ele tivesse as informações certas na hora certa. Hoje, é preciso ir além.

O que trava um projeto de IA agora é tudo aquilo que cerca o modelo: quem autoriza suas ações, quem audita seus resultados, o que ele consegue reter de uma execução para outra, até onde vai seu raio de ação, e se existe algum registro do que ele fez. Esse conjunto de mecanismos ganhou um nome — “harness”, ou estrutura de execução.

Vale notar que uma etapa não anula a anterior — ela engloba. Saber montar o contexto certo já pressupõe saber formular bem o pedido. E construir um harness robusto pressupõe as duas coisas anteriores, somando ainda um conjunto de capacidades que nem o melhor prompt nem o melhor contexto conseguem entregar sozinhos: gerenciamento de ferramentas, dupla checagem, memória entre sessões, controle de acesso, rastreabilidade, escolha inteligente de modelo e capacidade de aprender com os próprios erros.

Estatísticas recentes mostram que a esmagadora maioria dos projetos corporativos de agentes de IA — quase 9 em cada 10 — não sai do papel rumo à produção. E raramente é porque o modelo escolhido é fraco. O problema costuma estar em outro lugar: informações que se perdem ao longo de sessões longas, ausência de barreiras de segurança, incapacidade de manter estado entre uma interação e outra, ou mecanismos de correção que nunca fecham o ciclo. Coloque duas equipes usando exatamente o mesmo modelo, mas com estruturas de execução diferentes, e os resultados serão completamente distintos. O que separa sucesso de fracasso é essa estrutura — não o modelo em si.

Do que se trata, afinal

Pense no modelo como o cérebro bruto, a capacidade de raciocínio pura. O harness é o que transforma essa capacidade em algo em que se pode confiar na prática. É a ponte entre o raciocínio do modelo e as consequências reais no mundo: como as ferramentas são acionadas, como o trabalho é conferido, o que fica guardado na memória, quem pode fazer o quê, e o registro de tudo isso.

Uma estrutura madura tem, no fundo, sete frentes de trabalho — e cada uma delas resolve um tipo específico de problema.

Conteúdo do artigo

Primeira frente – ferramentas: quem manda nelas

Um princípio central: o modelo jamais deve executar uma ação por conta própria. Ele apenas propõe — indica qual função quer chamar e com quais parâmetros. Cabe à estrutura ao redor validar se o pedido faz sentido, se há permissão para aquilo, executar de fato, e devolver o resultado. Esse intermediário é justamente o que impede que uma tentativa de manipulação maliciosa vire execução de código sem controle.

Na prática, isso funciona como um sistema de rascunho seguido de aprovação. Ações que podem causar dano são propostas, mas ficam retidas até alguém confirmar. Coisas inofensivas, como apenas ler um dado, passam sem barreira nenhuma. Já ações que alteram ou apagam algo esperam luz verde.

Conteúdo do artigo

O ganho real aqui é que o agente nunca fica “no escuro”. Toda tentativa de usar uma ferramenta — tenha ela dado certo, sido barrada por falta de permissão, ou estourado o tempo — volta para o agente como uma resposta organizada. Isso poupa o sistema de ter que adivinhar o que aconteceu lendo uma saída de terminal crua e ambígua.

Segunda frente – loops de verificação: ninguém corrige a própria prova

Um princípio quase óbvio, mas frequentemente ignorado: quem produziu algo não deve ser também quem avalia se ficou bom. Um modelo tende a ser complacente com o próprio trabalho — ele já “acredita” na solução que deu, então uma segunda avaliação, feita por outra instância com instruções diferentes, tende a pegar falhas que passariam batido numa autoavaliação.

Conteúdo do artigo

Um episódio real ilustra bem isso: em certo momento de 2026, o Claude Code apresentou uma queda perceptível de qualidade. Ao investigar, a Anthropic identificou três alterações distintas na camada de estrutura — nada relacionado ao modelo em si: um ajuste que reduziu o esforço de raciocínio permitido, uma falha de cache que descartava parte do histórico de “pensamento” do modelo, e um prompt que restringia demais a verbosidade das respostas. O modelo continuava sendo o mesmo modelo. O que mudou foi tudo em volta dele — e isso bastou para degradar a experiência inteira. A empresa publicou uma análise pública do ocorrido. A conclusão não foi “o modelo precisa melhorar”; foi “a estrutura de execução é, na prática, a qualidade percebida do seu produto”.

Essa checagem independente não precisa ser cara. Coisas simples — o código compila? os testes passam? a mudança ficou dentro do que foi pedido? — podem ser verificadas por um modelo leve e barato. Guarde o modelo mais caro e poderoso para os casos que exigem julgamento de verdade. O que importa não é o preço do verificador, e sim o fato de ele ser separado de quem produziu o resultado.

Terceira frente – contexto e memória: o que fica na cabeça do agente

A lição da era anterior foi: o que você mostra ao modelo pesa mais do que como você formula a pergunta. O passo seguinte é deixar de depender de um humano acertando manualmente o que entra no contexto toda vez — e passar essa responsabilidade para a própria estrutura.

Um sistema bem construído resume o que já foi feito, descarta resultados de ferramentas que já cumpriram seu papel, e mantém na “mesa de trabalho” apenas o que a etapa atual realmente precisa. Sem essa disciplina, conversas longas acabam lotando a janela de contexto disponível, informação relevante começa a ser empurrada para fora, e a qualidade do raciocínio despenca aos poucos.

Conteúdo do artigo

A memória segue a mesma lógica, só que entre sessões diferentes, não dentro da mesma conversa. Regras, restrições e lições aprendidas ficam gravadas em arquivos que são recarregados automaticamente sempre que uma nova sessão começa. Assim, um erro cometido numa sessão anterior não se repete na próxima — porque a lição já está escrita em algum lugar que o sistema sempre consulta antes de agir. Sem esse hábito, cada sessão nasce do zero, sem aprender nada do passado. Com ele, o sistema realmente evolui ao longo do tempo.

Um teste simples para saber se isso está funcionando: se, quarenta interações depois, o agente ainda respeita uma restrição definida logo no início, a memória está fazendo seu trabalho. Se ela evapora bem antes disso, não está.

Quarta frente – Proteções (guardrails): as barreiras de proteção

Antes de qualquer resposta chegar ao usuário final ou a outro sistema, ela deveria passar por uma checagem contra regras estabelecidas. Isso deixou de ser um “extra” — regulamentações recentes (leis estaduais e regionais sobre IA, exigências de conformidade que já pedem prova de controles ativos sobre o que sistemas de IA produzem) tornaram isso praticamente obrigatório.

Um erro comum é tratar todo tipo de agente com o mesmo nível de rigor. Um assistente que só conversa com clientes não precisa das mesmas travas que um agente com poder de alterar um banco de dados de produção. O nível de exigência deveria acompanhar o risco real da tarefa — nem de menos, nem exageradamente mais.

Dá para pensar nessas travas em quatro grandes grupos: as que cuidam do tom e da segurança do conteúdo gerado; as que impedem vazamento de dados sensíveis ou informação pessoal identificável; as que controlam o que o agente pode ou não executar, principalmente ações irreversíveis; e as que limitam gasto — tempo, tentativas, custo em tokens — para que uma tarefa que deveria custar centavos não vire uma fatura de centenas de dólares por causa de um loop mal controlado.

Quinta frente – observabilidade: enxergar o que está acontecendo

Um agente que funcionava perfeitamente semana passada pode começar a falhar essa semana sem que uma única linha de código tenha mudado — o provedor do modelo pode ter feito um ajuste silencioso, uma API externa pode ter mudado o formato da resposta, ou simplesmente surgiu um caso de uso que nunca tinha sido testado. Sem visibilidade sobre o comportamento do sistema, você só descobre o problema quando ele já quebrou algo em produção. Com essa visibilidade, dá para perceber o desvio antes que vire dano de fato.

Times que conseguem acompanhar cada ação tomada por um agente, e identificar quando o comportamento começa a fugir do padrão, são os que conseguem dar mais autonomia ao sistema com segurança, aos poucos. Sem esse acompanhamento, cada nova liberdade concedida ao agente é um tiro no escuro; com ele, vira uma decisão baseada em dados reais.

Vale registrar cada chamada de ferramenta e seu desfecho — isso cria uma trilha auditável do que aconteceu. Vale medir não o volume total gasto, mas o custo por resultado realmente aproveitado — se a maioria do que o agente produz acaba sendo descartada, algo está desequilibrado. E vale comparar o padrão de comportamento de uma semana com o da anterior, para pegar uma eventual regressão antes que o usuário final perceba.

Sexta frente – roteamento e seleção de modelo: nem tudo precisa da artilharia pesada

Nem toda subtarefa exige o modelo mais potente disponível. Verificar formatação ou classificar um item não pede o mesmo poder de raciocínio que planejar uma mudança arquitetural complexa. Um sistema sem essa distinção manda tudo pelo modelo mais caro e reza para o orçamento aguentar. Um sistema bem desenhado escolhe, para cada etapa, o modelo mais econômico capaz de resolver aquilo — reservando o modelo topo de linha só para onde ele realmente faz diferença.

Conteúdo do artigo

A régua prática é simples: tarefas mecânicas e repetitivas vão para modelos rápidos e baratos; tarefas que exigem julgamento, planejamento ou raciocínio mais sofisticado vão para os modelos mais robustos. E essa escolha deve acontecer automaticamente, de acordo com o tipo de tarefa — sem depender de alguém lembrar de trocar manualmente o modelo no meio do processo.

Sétima frente – feedback e autoaperfeiçoamento: aprender com os próprios tropeços

Um sistema estático se comporta do mesmo jeito na centésima execução e na primeira. Um sistema que incorpora feedback, por outro lado, registra cada rejeição, cada estouro de tempo ou orçamento, e transforma isso em uma regra escrita — regra essa que toda execução futura vai consultar automaticamente.

Conteúdo do artigo

Isso não tem nada a ver com retreinar o modelo; os parâmetros internos dele permanecem intocados. O que muda é o ambiente ao redor: as regras ficam mais precisas, a escolha de modelo melhora, o contexto fica mais enxuto e relevante. Com o tempo, a etapa de verificação vai encontrando cada vez menos problemas, simplesmente porque as restrições acumuladas já impedem que os erros antigos se repitam.

Por que a maioria dos projetos não decola

Esse número alto de projetos que travam antes da produção não vem de modelos incapazes — vem de lacunas estruturais: etapas puladas, verificações ignoradas, desvios de comportamento que ninguém está monitorando. Alguns padrões se repetem:

Sessões longas acabam “esquecendo” restrições definidas no começo, porque o processo de resumir o histórico descarta instruções importantes ao longo do caminho — e o agente acaba fazendo exatamente aquilo que tinha sido proibido de fazer.

Quando não existe uma segunda checagem independente, o próprio agente valida seu trabalho — e tende a aprovar quase tudo que produz. Uma avaliação externa, feita por outra instância com critérios diferentes, revela uma fatia significativa de problemas que passariam despercebidos numa autoavaliação.

Sem controle de permissões por ferramenta, uma tentativa de manipulação externa — por exemplo, embutida no texto de uma tarefa ou ticket — pode virar execução de comando sem que nada a impeça no caminho.

Atualizações silenciosas feitas pelo provedor do modelo podem mudar sutilmente o comportamento do sistema, e sem uma referência de comportamento “normal” para comparar, isso pode passar batido por semanas.

A ausência de qualquer persistência entre sessões faz com que o mesmo contexto precise ser reconstruído do zero repetidamente, a um custo real — e os mesmos erros voltam a acontecer porque nada foi de fato aprendido.

E, sem limites claros de gasto, um agente preso num ciclo de tentativas repetidas pode gerar uma conta bem mais alta do que qualquer um esperava.

Em todos esses casos, o modelo em si não é o vilão. Troque-o por outro e o mesmo tipo de falha volta a acontecer. Ajuste a estrutura ao redor, e o mesmo modelo passa a funcionar bem. O momento ideal para pensar nessa estrutura é antes de qualquer usuário real interagir com o agente — não depois que o primeiro problema já causou estrago.

Os limites dessa abordagem

Uma estrutura de execução bem feita não conserta um objetivo mal definido. Se a tarefa em si é vaga, o sistema mais sofisticado do mundo vai simplesmente errar com muita consistência.

As travas de segurança também precisam de manutenção — permissões configuradas uma vez e nunca revisadas dão uma falsa sensação de controle; vale revisá-las periodicamente.

E existe o risco oposto: exagerar na quantidade de camadas de aprovação e verificação torna tudo lento e burocrático. Um sistema pensado para o setor financeiro, aplicado sem ajuste a um projeto pequeno e experimental, vai parecer desnecessariamente pesado. O nível de controle deveria ser proporcional ao risco real envolvido.

No fim das contas, essa estrutura é infraestrutura — não é o produto em si. Ninguém valoriza a estrutura de execução por ela mesma; o que importa é o resultado que o agente entrega através dela.

Para fechar

Se antes o desafio era formular bem uma pergunta, e depois passou a ser escolher bem o que mostrar ao modelo, agora o desafio é montar tudo o que cerca esse modelo para que ele possa operar de verdade em produção: quem autoriza suas ações, quem confere seu trabalho, o que ele carrega de uma sessão para outra, até onde ele pode ir, e se existe registro do que foi feito.

Continuar escolhendo qual modelo usar como se isso ainda fosse a decisão mais importante é responder a uma pergunta que já ficou para trás. O modelo é só o motor; a estrutura ao redor é o veículo inteiro. Não faz sentido entregar um motor sem nada em volta dele.

Não é preciso implementar tudo de uma vez. Comece pelo controle de ferramentas e por uma checagem básica de qualidade. Adicione memória quando perceber que as mesmas situações estão se repetindo entre sessões. Adicione travas de segurança quando o agente passar a interagir com algo visível ao cliente final. Adicione monitoramento quando precisar comprovar que o sistema está funcionando como esperado. Adicione escolha inteligente de modelo quando o custo começar a incomodar. E adicione a capacidade de aprender com os próprios erros quando quiser que o sistema realmente pare de tropeçar na mesma pedra.

São sete frentes de trabalho ao todo. Ignore a maioria delas e você tem, na melhor das hipóteses, uma demonstração interessante. Trabalhe nas sete, e você tem um sistema que efetivamente melhora a cada execução.

Fonte: Adaptado e resumido de: Harness Engineering: the skill that replaced prompt engineering in 2026 e publicado no LinkedIn

Indo mais a fundo: Agent Harness Engineering, by Addy Osman

As tais “Engenharias” do mundo de Agentes que se utilizam da IA Generativa

Conteúdo do artigo

Engenharia de Prompt: mensagem/comando que informa o papel, o contexto, as instruções, alguns exemplos e o formato de saída.

Engenharia de Contexto: é a memória. Trata de como armazenar e recuperar informações relevantes ao Agente de IA.

Engenharia de Harness: É a máquina. Trata de tudo que envolve o cérebro do Agente (Modelo): Contexto, ferramentas, subagentes, RAG, integrações (via APIs ou MSPs), tratamento de erros, …

Engenharia de Loop: é a execução iterativa. Um mecanismo que decide se a máquina deve ser executada novamente. Para isso é necessário um objetivo definido no princípio, limites como um número máximo de iterações ou um orçamento de custo, e um critério automático que determine quando a tarefa realmente terminou. Vide Engenharia de Loop: Como Construir Agentes que Melhoram o Próprio Trabalho

Engenharia de Graph: é a coordenação. Quando vários loops têm que trabalhar juntos, é necessário definir o que se executa, quando se executa, o que pode ser feito em paralelo e quais componentes supervisionam os outros.

Em resumo: Prompt e Contexto estão na fase de coleta do harness; Harness executa um ciclo completo; Loop decide se o ciclo deve ser repetido; Graph decide quais loops executar e como eles se coordenam.

Veja também:
Explicando: Engenharia de Prompt, de Contexto e de Harness – com a analogia de um Cavalo

Com o surgimento da IA Generativa e os Chats de IA, temos observado um aumento no uso de termos que envolvem “engenharia”: Engenharia de Prompt (2022–); Engenharia de Contexto (2025–); Engenharia de Harness (2026–). Três novos conceitos, cujas fronteiras ainda não estão totalmente definidas no setor.

A Anthropic descreve a engenharia de contexto como uma “evolução natural da engenharia de prompt”, e o artigo de Martin Fowler sobre “Engenharia de Harness”[1] organiza a engenharia de harness como uma forma de engenharia de contexto.

É fácil se perguntar quais são as diferenças reais, e com o objetivo de responder a questão, compartilho um modelo mental usando a metáfora da IA como um Cavalo Inteligente, de um artigo Japones que li recente para facilitar o entendimento. Este artigo trás uma abordagem geral, não entrando no assunto com profundidade.

Preparando o terreno

Você é dono de um cavalo. Você tem um cavalo incrivelmente inteligente à sua disposição.

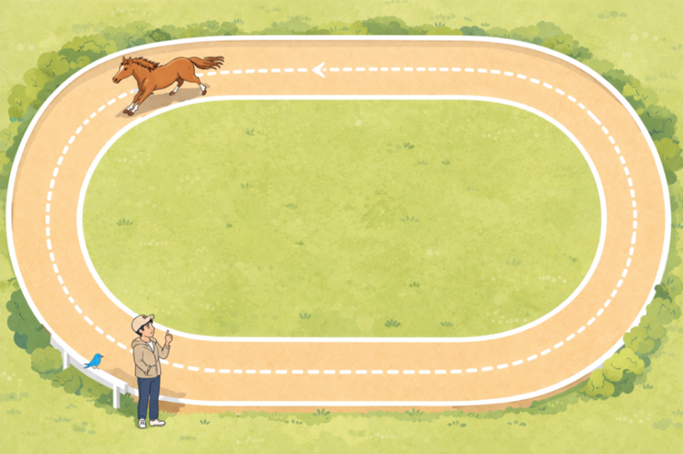
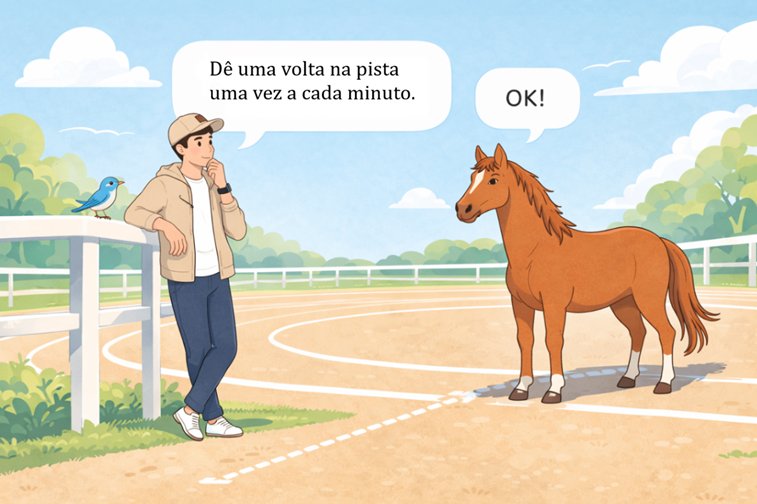
Tudo o que você quer que ele faça é: “Dê uma volta na pista uma vez a cada minuto.”

Simples, não é? Mas a questão é que é surpreendentemente difícil fazer o cavalo executar corretamente esse “pedido simples”.

Imagem adaptada da original em Japonês

1. Engenharia de Prompt — A Arte de “Questionar”

Trata-se de transmitir “o que constitui sucesso” de uma forma que o cavalo (a IA) não possa interpretar erroneamente.

A habilidade do cavalo não muda. O que muda é a forma como o humano se comunica. Esta é a parte fascinante da engenharia de instruções: mesmo que você peça a mesma coisa para a mesma IA, os resultados podem mudar drasticamente dependendo de como você formula a pergunta.

Chamada Ambígua

Dono: “Dê uma volta na pista uma vez a cada minuto.”

Cavalo: “OK!”

O cavalo correu “uma vez”. No entanto, ele simplesmente correu em linha reta de uma ponta à outra do campo e voltou, dizendo: “Pronto, consegui!”

O cavalo não estava relaxando. Acontece que a definição de “dar a volta na pista” era ambígua.

Cavalo cortou caminho, devido a instruções ambíbuas

Instruções corretas

Dono: “Corra ao longo da linha branca da pista, sem atalhos, e retorne ao ponto de partida após uma volta.”

Cavalo: “Entendido!”

Desta vez, ele seguiu a linha branca corretamente, completou a volta e retornou.

Um cavalo correndo corretamente devido a instruções claras

Resumo: A Engenharia de Prompts (comandos) consiste em “aprimorar a forma como você se comunica com a IA”. Mas sua essência não se resume a técnicas superficiais; trata-se de “não deixar critérios de sucesso ambíguos”.

2. Engenharia de Contexto — A Arte de “Mapas e Relatórios de Reconhecimento”

Trata-se de projetar todo o conjunto de informações que você mostra à IA em qualquer momento.

Se o Prompt é sobre “o que fazer”, então o Contexto é sobre “o que mostrar”.

O importante aqui é que mais informação nem sempre é melhor. A Anthropic menciona que “o contexto deve ser tratado como um recurso finito”[2], e a OpenAI escreve que “manuais de instruções extensos podem ocultar informações importantes”[3].

Forneça as informações necessárias, no momento necessário e na quantidade necessária. De forma simples, clara e objetiva.

Correndo Sem Contexto

A instrução era perfeita. Mas…

Condição do terreno: Há um buraco a 10 m do ponto de partida.

Dono: “Corra ao longo da linha branca da pista, sem atalhos, e retorne ao ponto de partida após uma volta.”

Cavalo: “OK!” Cavalo: Plop 💀

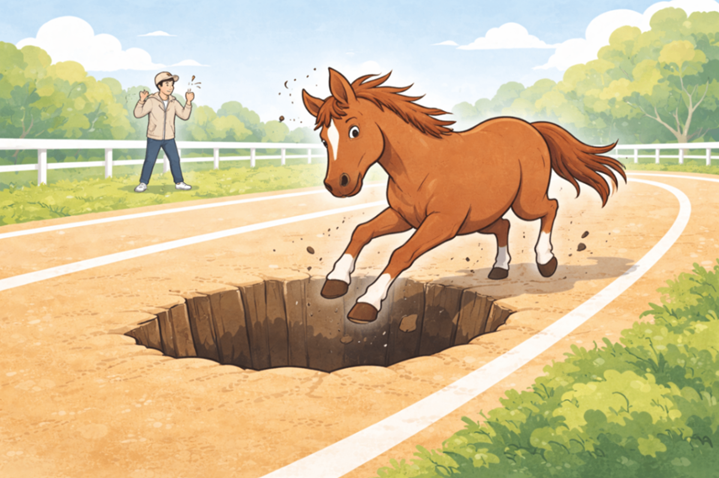
A instrução foi perfeita “Corra ao longo da linha branca da pista, sem atalhos, e retorne ao ponto de partida após uma volta.”, mas o cavalo não conhecia as condições do percurso.

Um cavalo caindo em um obstáculo

Fornecendo Contexto

Dono: “Corra ao longo da linha branca, sem atalhos, uma volta.”, porém “Considere esta anotação (bilhete)”

[Bilhete]: “Obstáculo na marca de 10m. Salte para passar.”

Cavalo: “Entendido, bilhete lido!”

Cavalo: (Salta na marca de 10m → Evita o obstáculo)

Esta é a base da engenharia de contexto: passar as informações básicas necessárias como um conjunto antes do início.

Cavalo conferindo o bilhete e saltando sobre o obstáculo

Mas, na verdade, isso não é tudo.

É aqui que a engenharia de contexto fica realmente interessante.

Não se trata apenas de passar um “bilhete” antecipadamente; também inclui fornecer informações em tempo real enquanto a prova está em andamento.

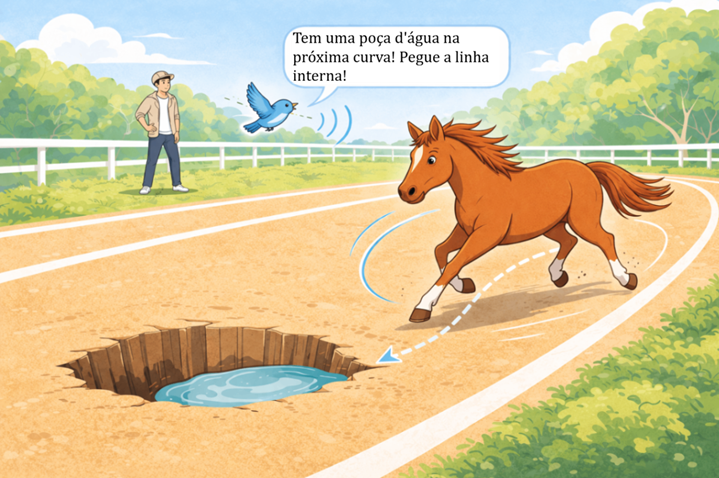
Pássaro Escoteiro 🐦 (uma função para explorar o terreno e transmitir informações): “Há uma poça na próxima curva! Passe por dentro!”, “Entrando na reta! Livre! Velocidade máxima permitida!”

Cavalo desvia o obstáculo, pois recebeu instruções durante o percurso

Durante a corrida, o pássaro escoteiro transmite apenas as informações necessárias para aquele trecho, no momento certo. Talvez essa seja a essência de engenharia de contexto.

Resumo: A engenharia de contexto não se resume a entregar um “aviso” antes da corrida; trata-se também de transmitir informações no momento apropriado.

  • O aviso antes da corrida = Instruções do sistema, conhecimento prévio.
  • Informações de reconhecimento durante a corrida = RAG (busca/recuperação de informações externas), feedback dos resultados da execução da ferramenta.

Projetar “o que mostrar neste exato momento”. É isso que eu acredito ser a engenharia de contexto.

3. Engenharia de Harness — A Arte de “Todo o Sistema”

Trata-se de projetar todo o sistema para garantir que a IA funcione de forma estável.

Harness originalmente se referia a “equipamentos” ou “arreios” para um cavalo. Rédeas, sela, estribos — um conjunto de ferramentas para maximizar a potência do cavalo, impedindo-o de correr descontroladamente.

No mundo da IA, engloba tudo no sistema de execução fora do modelo — ferramentas, restrições, ciclos de feedback e mecanismos de verificação.

Se os comandos e o contexto são sobre “trabalhar com o cavalo”, então a engenharia de Harness é o sentido de “manter o palco onde o cavalo corre”.

Por que Precisamos de Harness?

Os comandos e o contexto são perfeitos. Mas…

  • O cavalo ocasionalmente se desvia do caminho.
  • Os resultados são ligeiramente diferentes a cada vez.
  • Mesmo que corra a toda velocidade na direção errada, ninguém pode pará-lo.

Para uma única solicitação, um bom comando + um bom contexto são suficientes. Mas agora que temos mais cenários em que pedimos a uma IA para “trabalhar autonomamente por uma hora“, a falta de estabilidade sistêmica é assustadora.

É aí que entra a engenharia de Harness (sistemas de controle).

Os Quatro Elementos de um Sistema de Controle

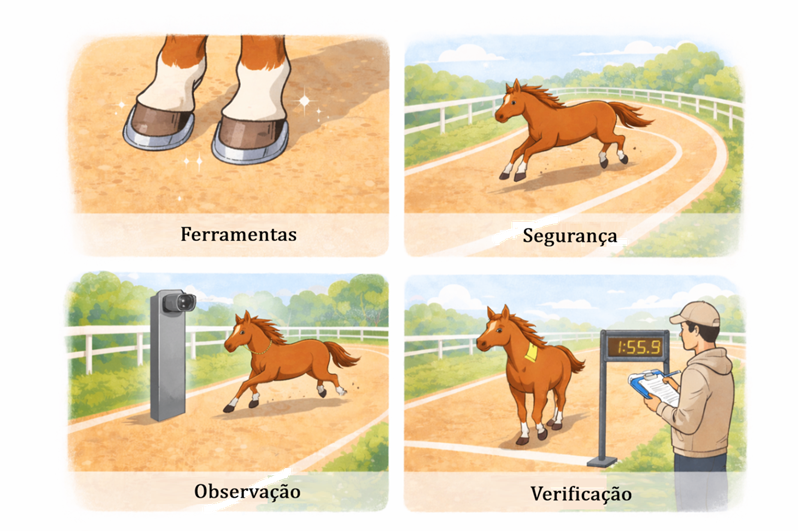
Os qutro elementos de Harness

Os quatro elementos de um sistema de controle (Harness): Ferramentas, Grades de Proteção para segurança (Guardrails), Pontos de Verificação e Loops de Verificação

Ferramentas — Equipando-se com Ferraduras

Correr com ferraduras é mais rápido e estável do que correr descalço. Se houver obstáculos, podemos até fornecer rampas de salto.

No mundo da IA → Definições de ferramentas como leitura/gravação de arquivos, busca na Web e execução de código.

Grades de Proteção — Cercas para impedir que o sistema saia do percurso

Não importa a velocidade, é inútil se o sistema sair do percurso. Como há uma cerca, o sistema pode correr em velocidade máxima com tranquilidade.

No mundo da IA → Controle de permissões, ambientes isolados (sandboxes) e restrições em operações executáveis.

Observação — Sensores de Ponto de Controle

Posicione sensores em pontos-chave do percurso para registrar tempos de volta e trajetórias. Avise imediatamente se houver desvios.

No mundo da IA → Ganchos (processamento executado automaticamente antes/depois de ações específicas), registros e monitoramento.

Ciclo de Verificação — Reflexão após o objetivo

“Perdi 0,5 segundos na segunda curva desta vez. Na próxima vez, mudarei o ângulo de entrada.” Crie um ciclo para refletir os resultados na próxima corrida.

No mundo da IA → Execução de testes, obtenção de resultados de CI (Integração Contínua), avaliação e ciclos de melhoria.

Juntando tudo…

Gerente de Equipamentos: “Poços preenchidos. Cercas construídas. Sensores instalados nos pontos de controle. Ferraduras substituídas por novas.”

Proprietário (Instruções): “Corra ao longo da linha branca, sem atalhos, uma volta.”

Olheiro (Contexto): “A grama está molhada depois da curva, então diminua a velocidade.”

Cavalo: “Entendido, a toda velocidade!”

→ Resultado estável, consistente e de alto desempenho sempre.

Resumo: A Engenharia de Harness não se resume a “reunir ferramentas”.

Trata-se do projeto de todo o sistema para que o cavalo continue correndo de forma estável, incluindo ferramentas, restrições, observações e ciclos de verificação.

Para uma única pergunta, um bom enunciado é suficiente. Mas se você estiver pedindo um trabalho autônomo como “refatorar toda a base de código em uma hora”, sem ferraduras (ferramentas), cercas (restrições), pontos de verificação (observação) e tempos de volta (verificação), o cavalo eventualmente sairá da estrada.

Relações entre os três

Não acredito que esses três sejam coisas que você escolhe entre si. Eles funcionam como camadas sobrepostas. Estrutura em camadas das três disciplinas da engenharia:

  • Engenharia de Prompt← O que fazer (instruções)
  • Engenharia de Contexto ← O que mostrar (todas as informações necessárias para IA)
  • Engenharia de Harness ← Como executar, verificar e corrigir isso (tools / constraints / monitoring / loops)

Além disso, as camadas necessárias aumentam dependendo da complexidade do que você deseja alcançar.

Resultado Desejado e Camadas Necessárias:

  • Obter uma boa resposta do ChatGPT >> Prompt
  • Permitir que ele consulte documentos da empresa com RAG >> Prompt + Contexto
  • Fazer um agente de IA escrever código autonomamente >> Prompt + Contexto + Harness

Conclusão

Se a IA é um “cavalo inteligente”, acredito que nós, humanos, temos três tarefas:

  • Transmitir o que você quer que seja feito sem mal-entendidos (Prompt)
  • Mostrar as informações necessárias para a execução de forma adequada (Contexto)
  • Configurar todo o mecanismo para funcionar de forma estável (Controle)

Não domine apenas uma… Somente quando as três estiverem presentes é que o cavalo poderá ter o melhor desempenho.

Os cavalos estão ficando mais inteligentes. Acredito que o que está sendo questionado agora é a nossa própria capacidade de design como cavaleiros.

Fonte: Understanding Prompt Engineering, Context Engineering, and Harness Engineering through the Metaphor of a Horse – 10 de abril de 2016

Referências

Muito Além do Hype: Um Roteiro Realista para Líderes diante da GenAI em 2025 e no Futuro

O cenário atual está saturado de declarações arrojadas e demonstrações chamativas feitas por entusiastas da inteligência artificial – muitas vezes, porém, sem a devida responsabilidade. Esse entusiasmo exagerado alimentou expectativas distorcidas sobre as reais capacidades da GenAI. Executivos têm sido levados a crer que os modelos de linguagem generativa e de grande porte serão o epicentro de uma nova era de “empresas nativas de IA”, prontas para reinventar negócios e destravar crescimento exponencial. No entanto, essa revolução ainda está longe de se concretizar para a maioria das organizações. Uma pesquisa da Cisco realizada no início de 2025 com mais de 2.500 CEOs revelou que, embora 97% tenham planos de incorporar IA em suas operações, apenas 2% se consideram realmente preparados para isso.

O problema é que discursos eufóricos frequentemente ocultam os desafios reais da adoção de IA, negligenciam suas limitações e reduzem sua complexidade a uma visão simplista. Isso faz com que muitas empresas avancem sem uma compreensão clara dos custos e obstáculos. Quando essas iniciativas falham – o que não é raro – a credibilidade da tecnologia é minada, bem como a confiança nos profissionais que promovem sua adoção de maneira responsável. É hora de abandonar a fantasia e focar no que realmente importa: enfrentar as realidades práticas para que a IA possa, de fato, trazer resultados sustentáveis.

O Panorama Real e Baseado em Dados da Adoção da GenAI

Superar o otimismo exagerado exige ancorar as decisões em dados concretos. Um estudo do Boston Consulting Group, divulgado no final de 2024 e baseado em entrevistas com 1.000 líderes executivos, mostrou que 74% das empresas ainda não avançaram de forma significativa em suas iniciativas com IA – muitas estão empacadas na fase de testes e protótipos. Em diversas situações, a implementação se limita a apresentações para investidores e conselhos, com pouca ou nenhuma ação efetiva. Isso se deve, em grande parte, ao fato de que a tecnologia ainda não amadureceu o suficiente para atender às elevadas expectativas criadas.

Mesmo entre as organizações consideradas avançadas em IA, apenas 4% conseguiram desenvolver soluções robustas que entregam valor consistente. Outros 22% começaram a perceber alguns benefícios, mas só após anos de investimento. E esse levantamento inclui todas as vertentes de IA, o que sugere que os números da GenAI, especificamente, são ainda mais modestos. De fato, o CEO da Microsoft, Satya Nadella, apontou que o retorno da GenAI, neste momento, é praticamente nulo.

Esse padrão não é isolado. A Deloitte, em seu relatório do terceiro trimestre de 2024, identificou que apenas 32% dos experimentos com GenAI evoluíram para a produção, com os demais enfrentando obstáculos como falta de confiabilidade, preocupações com privacidade e segurança. No setor público, a taxa de adoção não ultrapassa 3% em nenhuma função de negócio. A McKinsey, por sua vez, mostrou que apenas 11% das empresas pesquisadas haviam adotado a GenAI em escala até o fim de 2024.

Ou seja, a adoção da GenAI está muito aquém das promessas feitas por seus defensores mais entusiasmados. Para a maioria das empresas, ela ainda é apenas um experimento, e seu impacto revolucionário no mundo corporativo continua distante. Alcançar essa transformação exigirá tempo, esforço em treinamento, ajustes culturais e avanços tecnológicos substanciais.

Modelos de Implementação: Lições da IBM e da BMW

Os líderes que realmente desejam transformar suas organizações com GenAI enfrentam dois grandes desafios: construir uma estratégia prática e garantir que ela esteja em sintonia com os valores da empresa. IBM e BMW ilustram bem como isso pode ser feito com seriedade e profundidade.

A IBM adota uma abordagem metódica, focada na operacionalização da IA, estruturada em oito passos:

  1. Definir objetivos concretos, convertendo problemas em metas mensuráveis.
  2. Avaliar os dados disponíveis, priorizando qualidade, consistência e conformidade regulatória.
  3. Selecionar a tecnologia adequada, considerando o tipo de tarefa a ser automatizada.
  4. Montar uma equipe capacitada, integrando técnicos e profissionais com visão de negócio.
  5. Estimular uma cultura de experimentação, com pilotos para validação de ideias.
  6. Estabelecer diretrizes éticas, com foco em segurança, privacidade e eliminação de vieses.
  7. Testar rigorosamente os modelos, com indicadores de desempenho claros.
  8. Planejar para escalar e evoluir, preparando a solução para o crescimento organizacional.

Mas operacionalizar é apenas uma parte do desafio. A BMW, por exemplo, complementa a execução técnica com uma dimensão ética e humana clara, com cinco princípios orientadores:

  • Respeito à coexistência entre humanos e sistemas digitais.
  • Compromisso inegociável com a segurança dos dados e do uso da tecnologia.
  • Promoção da transparência e cooperação como base para confiança.
  • Inclusão e capacitação contínua para democratizar a IA.
  • Sustentabilidade digital voltada ao bem-estar ambiental e social.

Para a BMW, a IA deve ampliar o bem-estar humano, e não apenas aumentar a eficiência. A verdadeira transformação ocorre quando os líderes equilibram a execução técnica com o propósito humano.

GenAI Não é Varinha Mágica – É Tecnologia com Limites

No mundo corporativo real, empresas como IBM e BMW precisam lidar com ambientes incertos, ambíguos e voláteis. Por isso, embora o potencial da GenAI seja promissor, ela ainda está sendo aplicada de forma limitada, em testes pontuais. A tecnologia não é infalível: pode cometer erros graves, reforçar preconceitos e até causar danos quando aplicada sem supervisão rigorosa.

Há casos absurdos e perigosos – como um chatbot sugerindo cola como ingrediente culinário ou um sistema de IA duplicando indevidamente uma dosagem médica. Embora empresas como a OpenAI estejam investindo pesado no aperfeiçoamento dos modelos, especialistas admitem que as chamadas “alucinações” dos LLMs ainda não são plenamente controláveis – e quanto mais sofisticadas se tornam as respostas, mais difícil é identificar essas falhas.

Essa limitação é uma razão forte para manter a GenAI afastada de decisões críticas sem uma supervisão humana sólida.

A Falácia da Transformação Instantânea

Existe também o mito de que a GenAI irá, em pouco tempo, derrubar estruturas hierárquicas tradicionais e impulsionar organizações dinâmicas, baseadas em times fluidos. A realidade é bem menos glamorosa. Hierarquias continuam sendo necessárias para garantir clareza, responsabilidade e escalabilidade, especialmente em empresas grandes e complexas.

Sim, a IA vai transformar funções, e sim, alguns cargos intermediários vão desaparecer. Mas essas mudanças serão graduais. Gestores intermediários, por exemplo, passarão a atuar mais como facilitadores entre humanos e máquinas, coordenando tarefas híbridas e aproveitando o melhor dos dois mundos.

A transformação será evolutiva, e não revolucionária. E será lenta, complexa e cara. Entre as barreiras mais comuns estão:

  • Alto custo de implementação, incluindo tecnologia e talentos.
  • Infraestrutura de TI defasada, muitas vezes incompatível com os requisitos da IA.
  • Dependência de dados limpos e consistentes, algo que muitas empresas ainda não têm.
  • Resistência dos funcionários, seja por medo de substituição ou desconfiança.
  • Riscos de governança, como vieses e brechas de segurança.
  • Problemas de confiabilidade, que exigem validação constante e intervenção humana.

Esses desafios tornam a transformação algo que se mede em anos – não em meses. É necessário encarar o processo com realismo, paciência e disciplina estratégica.

Como os Líderes Podem Gerar Valor Real com IA

Liderar com IA exige foco estratégico e execução pragmática. Os líderes mais bem-sucedidos serão aqueles que trocarem o espetáculo pela substância e priorizarem ações baseadas na realidade da própria organização. Eis alguns princípios fundamentais:

  • Escolher casos de uso bem definidos, com alto potencial de impacto. Começar pequeno, mas com foco.
  • Adotar uma mentalidade de aprendizado contínuo, testando e refinando as aplicações conforme os dados e os resultados surgem.
  • Investir fortemente em dados, garantindo que a base sobre a qual a IA opera seja sólida, limpa e bem governada.
  • Capacitar as pessoas, não substituí-las. A IA deve ser usada para amplificar o talento humano, e não para substituí-lo.
  • Estabelecer governança sólida e ética, com comitês interdisciplinares voltados à segurança, privacidade e conformidade.
  • Ter visão de longo prazo, evitando promessas vazias. Resultados sustentáveis virão com esforço contínuo e bem direcionado.

Conclusão

A era da GenAI pode, de fato, inaugurar uma nova fase nos negócios – mas não sem liderança consciente e realista. As organizações mais bem preparadas para esse futuro não serão as que surfam no hype, mas as que sabem distinguir o que é relevante do que é ruído. O verdadeiro sucesso virá da paciência, da clareza estratégica e do compromisso com as pessoas e com os resultados mensuráveis.

Referência

California Management Review: Cutting Through the AI Hype: The Facts Leaders Need to Know About GenAI Adoption and Return on Investment, by Brian R. Spisak and Gary Marcus.

👥 Vamos conversar! Você já está trabalhando com GenAI na sua organização? O que tem funcionado? O que ainda parece um desafio? Compartilhe suas experiências e aprendizados nos comentários.

📌 Se este artigo fez sentido para você, curta e compartilhe com colegas que também estão tentando navegar pela IA com realismo e estratégia.