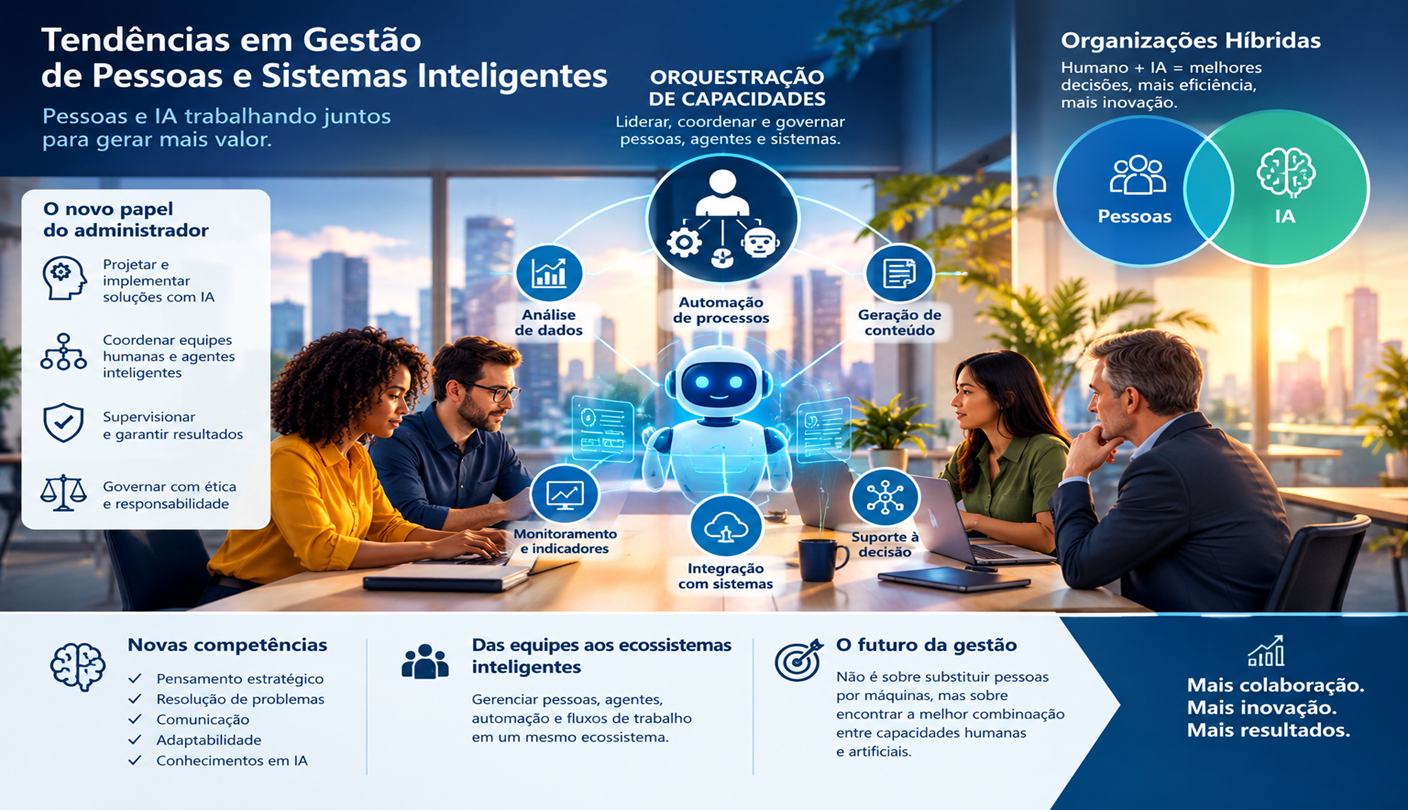
Gestão de Pessoas e Sistemas Inteligentes

Durante décadas, os programas de formação de gestores foram estruturados em torno de conceitos como estratégia, finanças, marketing, operações, gestão de pessoas e processos organizacionais. Esses fundamentos continuam essenciais, mas o ambiente empresarial contemporâneo introduz uma nova dimensão: a necessidade de administrar organizações nas quais pessoas e sistemas inteligentes passam a trabalhar de forma integrada [1][2][3].

A expansão da Inteligência Artificial Generativa e, mais recentemente, dos sistemas baseados em Agentes de Inteligência Artificial, está modificando a maneira como as organizações tomam decisões, executam processos, interagem com clientes e gerenciam conhecimento. Pesquisas recentes indicam que as organizações estão avançando da experimentação de IA para sua integração em processos e atividades de trabalho, enquanto cresce a perspectiva de equipes compostas por profissionais humanos e agentes inteligentes [2][3][5].

Nesse cenário, a formação do administrador precisa evoluir para preparar profissionais capazes não apenas de utilizar ferramentas de IA, mas de projetar, coordenar, supervisionar e governar ambientes híbridos, compostos por pessoas, agentes inteligentes e sistemas corporativos [2][4][7].

Da gestão de recursos à orquestração de capacidades

No modelo tradicional, o gestor coordena pessoas, recursos financeiros, ativos físicos, tecnologias e processos. Em uma organização cada vez mais digital, parte das atividades anteriormente realizadas exclusivamente por profissionais passa a ser executada ou apoiada por sistemas inteligentes [1][3].

Um agente de IA pode, por exemplo, analisar informações, consultar sistemas corporativos, elaborar relatórios, monitorar indicadores, executar determinadas tarefas, interagir com outros sistemas e até coordenar sequências de atividades. Dessa forma, a questão deixa de ser simplesmente “como utilizar IA?” e passa a ser: “Como administrar uma organização na qual seres humanos e sistemas inteligentes compartilham responsabilidades?”

Essa mudança exige uma ampliação da visão tradicional de liderança. O administrador do futuro deverá compreender não somente como liderar equipes humanas, mas também como orquestrar agentes, automações e fluxos de trabalho inteligentes [2][3][4].

A emergência da organização híbrida

As organizações tendem a assumir estruturas cada vez mais híbridas, nas quais trabalhadores humanos e sistemas de IA desempenham papéis complementares [2][3][5].

Pessoas continuarão sendo fundamentais para atividades que envolvem criatividade, julgamento, negociação, empatia, liderança, relacionamento e tomada de decisões em situações ambíguas. Sistemas inteligentes, por outro lado, poderão assumir uma parcela crescente de atividades relacionadas a processamento de informações, análise, monitoramento, geração de conteúdo, automação de processos e suporte à tomada de decisão [1][3][6].

Nesse contexto, o desafio da Administração não será simplesmente substituir pessoas por máquinas, mas determinar qual combinação entre capacidades humanas e capacidades artificiais produz melhores resultados organizacionais [3][4][6].

Com isso, o gestor precisa aprender a distribuir trabalho não apenas entre pessoas, mas entre pessoas, sistemas e agentes inteligentes.

A evolução das competências profissionais reforça essa necessidade. O World Economic Forum aponta mudanças significativas nas competências exigidas pelo mercado de trabalho até 2030, enquanto pesquisas com empregadores indicam crescimento da importância de conhecimentos relacionados à IA combinado à permanência de competências como pensamento estratégico, resolução de problemas, comunicação e adaptabilidade [1][6].

Consequentemente, conceitos tradicionais de desenho organizacional, estrutura hierárquica, divisão do trabalho, delegação e controle precisam ser revisitados.

Do gerenciamento de equipes à coordenação de ecossistemas inteligentes

A gestão de pessoas continuará sendo um dos pilares da Administração, mas deverá incorporar novas competências.

Um gestor poderá, por exemplo, liderar uma equipe formada por profissionais de diferentes especialidades e, simultaneamente, supervisionar agentes responsáveis por determinadas funções. Um agente poderá realizar análises de mercado; outro poderá monitorar indicadores financeiros; outro poderá apoiar o atendimento ao cliente; outro poderá automatizar atividades operacionais.

Nesse ambiente, o gestor passa a atuar como um coordenador de um ecossistema sociotécnico [2][3][4].

O próprio conceito de agent boss, apresentado no Work Trend Index da Microsoft, aponta para uma possível evolução do papel profissional: indivíduos que não apenas executam seu próprio trabalho, mas também constroem, delegam tarefas e supervisionam agentes de IA [2].

Isso exige competências como:

  • definir responsabilidades entre humanos e sistemas;
  • estabelecer objetivos e critérios de desempenho;
  • supervisionar decisões produzidas por agentes;
  • avaliar riscos e limitações dos sistemas inteligentes;
  • estabelecer mecanismos de aprovação e intervenção humana;
  • administrar exceções e situações não previstas;
  • garantir segurança, privacidade e conformidade;
  • desenvolver competências digitais nas equipes;
  • avaliar continuamente o desempenho dos agentes [2][3][4][7].

Assim, a liderança deixa de estar relacionada exclusivamente à gestão de pessoas e passa a envolver também a gestão da interação entre pessoas e inteligência artificial [2][4].

A importância da alfabetização em Inteligência Artificial

Outra tendência importante é a necessidade de desenvolver uma alfabetização em IA para gestores.

Isso não significa transformar administradores em programadores ou especialistas em ciência de dados. Significa capacitá-los para compreender os conceitos fundamentais que permitem avaliar criticamente tecnologias baseadas em IA e tomar decisões gerenciais mais qualificadas [6][7].

Um administrador deverá compreender conceitos como modelos de linguagem, IA generativa, agentes autônomos, automação, dados, APIs, sistemas de recomendação, aprendizado de máquina, avaliação de modelos, alucinações, vieses algorítmicos e segurança.

Mais importante ainda, deverá compreender quando utilizar IA, quando não a utilizar e como estabelecer mecanismos de controle quando ela for utilizada [4][7][8].

A formação executiva precisa, portanto, ultrapassar o ensino instrumental de ferramentas. Aprender a utilizar uma determinada aplicação de IA pode ser útil hoje, mas o conhecimento mais duradouro está relacionado à compreensão dos princípios que permitem avaliar novas tecnologias à medida que elas surgem.

Agentes de IA e a transformação dos processos organizacionais

A evolução dos agentes de IA representa uma mudança particularmente importante para a Administração.

Uma ferramenta tradicional de software normalmente executa funções previamente determinadas. Um agente inteligente, por sua vez, pode receber um objetivo, interpretar informações, planejar uma sequência de ações, utilizar ferramentas, interagir com sistemas e adaptar sua atuação de acordo com os resultados obtidos.

Isso aproxima a tecnologia de uma espécie de força de trabalho digital [2][5].

A pesquisa da McKinsey mostra que a experimentação com agentes de IA já ocorre em uma parcela significativa das organizações pesquisadas, embora muitas empresas ainda estejam em fases iniciais de implementação e escalabilidade [5].

Essa perspectiva terá impactos profundos sobre disciplinas como Gestão de Operações, Administração de Processos, Recursos Humanos, Estratégia e Gestão de Projetos.

O desenho de processos poderá passar a considerar simultaneamente:

Pessoas → Agentes → Sistemas → Dados → Processos → Decisões

O administrador precisará compreender como esses elementos se conectam e como estabelecer uma arquitetura organizacional capaz de gerar valor sem perder controle, transparência e responsabilidade [3][4][5][7].

Novas competências para o administrador

Nesse novo contexto, os programas de pós-graduação em Administração tendem a ampliar o conjunto de competências desenvolvidas [1][6][7].

Entre as competências mais relevantes estão:

1. Pensamento estratégico orientado por dados

O gestor deverá ser capaz de combinar experiência, conhecimento de negócio, dados e análises produzidas por sistemas inteligentes para tomar decisões melhores [1][6].

2. Gestão de sistemas inteligentes

Será necessário compreender como selecionar, implementar, supervisionar e avaliar agentes e soluções de IA utilizados pela organização [5][7].

3. Orquestração humano-IA

O administrador deverá determinar quais atividades devem ser executadas por pessoas, quais podem ser automatizadas e quais devem permanecer sob responsabilidade humana [2][3][4].

4. Pensamento sistêmico

À medida que diferentes agentes e sistemas passam a interagir, decisões locais podem produzir consequências em outras áreas da organização. O gestor precisará compreender essas interdependências [3][4].

5. Governança de IA

Questões relacionadas a segurança, privacidade, explicabilidade, responsabilidade, auditoria, conformidade e gestão de riscos tornar-se-ão parte da agenda administrativa [7][8].

6. Liderança em ambientes de transformação

A adoção de IA não é apenas uma transformação tecnológica. Ela altera funções, competências, processos, estruturas de poder e modelos de trabalho. O gestor precisará liderar essa transformação [3][4].

7. Experimentação e aprendizagem contínua

A velocidade de evolução da IA torna insuficiente um modelo educacional baseado apenas em conhecimentos estáveis. O profissional deverá desenvolver capacidade permanente de aprender, experimentar e adaptar-se [1][6].

Da sala de aula tradicional ao laboratório de organizações inteligentes

Essa transformação também exige mudanças na própria metodologia de ensino da pós-graduação.

Aulas predominantemente expositivas podem ser complementadas por laboratórios de gestão, nos quais os alunos enfrentem problemas organizacionais reais utilizando dados, ferramentas digitais e agentes de IA.

Essa abordagem é coerente com o movimento de escolas de negócios que estão incorporando IA não apenas como objeto de estudo, mas também como parte dos processos de ensino e aprendizagem [7]. A UNESCO, por sua vez, destaca a necessidade de uma abordagem centrada no ser humano para a utilização da IA generativa na educação, incluindo questões de competências, avaliação, ética e privacidade [8].

Em vez de simplesmente estudar um caso empresarial, por exemplo, os alunos poderiam receber um problema estratégico e utilizar diferentes agentes para:

  • pesquisar informações;
  • analisar dados;
  • identificar cenários;
  • elaborar alternativas;
  • simular decisões;
  • avaliar riscos;
  • construir planos de ação.

O papel do professor também se transforma. Em vez de ser apenas o principal transmissor de conhecimento, passa a atuar cada vez mais como mentor, curador, provocador e avaliador do processo de aprendizagem [7][8].

A questão central deixa de ser apenas saber se o aluno chegou à resposta correta. É necessário avaliar como ele formulou o problema, quais informações utilizou, como interagiu com os sistemas inteligentes, como avaliou as respostas produzidas pela IA e quais critérios empregou para tomar sua decisão [8].

A avaliação acadêmica também precisará mudar

A presença de IA Generativa cria um desafio importante para os modelos tradicionais de avaliação.

Trabalhos escritos, pesquisas, apresentações e exercícios podem ser produzidos parcialmente com auxílio de sistemas de IA. Proibir simplesmente essas tecnologias tende a ser menos efetivo do que ensinar os estudantes a utilizá-las de maneira responsável e crítica [7][8].

A avaliação pode migrar progressivamente do produto final para o processo de raciocínio e tomada de decisão.

Por exemplo, o estudante pode ser solicitado a:

  1. formular um problema empresarial;
  2. desenvolver uma estratégia de investigação;
  3. utilizar agentes de IA para explorar o problema;
  4. verificar criticamente os resultados;
  5. confrontar diferentes hipóteses;
  6. tomar uma decisão;
  7. justificar suas escolhas;
  8. avaliar os riscos e limitações da solução.

Esse modelo avalia competências que serão efetivamente relevantes no mundo profissional e está alinhado à preocupação de instituições educacionais em repensar avaliação e aprendizagem diante da IA generativa [7][8].

Estratégia, IA e vantagem competitiva

Outra tendência importante será integrar Inteligência Artificial às disciplinas tradicionais de estratégia.

A vantagem competitiva não dependerá apenas de possuir acesso às mesmas tecnologias de IA disponíveis para os concorrentes. Se as ferramentas se tornam amplamente acessíveis, o diferencial passa a estar na capacidade da organização de integrá-las aos seus processos, dados, conhecimento, cultura e modelo de negócio [3][5].

Nesse sentido, o ensino de Administração deve ajudar o aluno a responder perguntas como:

  • Onde a IA pode gerar vantagem competitiva?
  • Quais processos devem ser automatizados?
  • Quais capacidades precisam permanecer humanas?
  • Como a organização pode criar barreiras competitivas a partir de dados e conhecimento?
  • Como medir o retorno dos investimentos em IA?
  • Como administrar riscos associados à automação?
  • Como redesenhar funções e estruturas organizacionais?

A IA passa, portanto, de uma disciplina predominantemente tecnológica para um componente estratégico da Administração [3][5][7].

O novo papel da pós-graduação

A pós-graduação em Administração possui uma posição privilegiada nesse processo porque seu objetivo não deve ser simplesmente acompanhar as tecnologias emergentes, mas preparar profissionais capazes de liderar organizações em ambientes de mudança permanente [1][6][7].

O administrador do futuro provavelmente não será aquele que conhece profundamente uma determinada ferramenta de IA. Será aquele que sabe identificar problemas relevantes, formular boas perguntas, combinar competências humanas e artificiais, avaliar alternativas e transformar tecnologia em resultados organizacionais.

Os estudos do mercado de trabalho reforçam essa combinação. Ao mesmo tempo em que conhecimentos relacionados à IA ganham importância, empregadores continuam valorizando competências humanas como pensamento crítico, resolução de problemas, comunicação, adaptabilidade e liderança [1][6].

Isso significa que a educação executiva precisará equilibrar três dimensões:

Conhecimento + Tecnologia + Julgamento

O conhecimento fornece fundamentos. A tecnologia amplia a capacidade de análise e execução. O julgamento humano estabelece prioridades, interpreta contextos, considera valores, avalia riscos e assume responsabilidade pelas decisões [3][4][6].

Conclusão: formar gestores para organizações aumentadas pela inteligência

A principal transformação no ensino de Administração não está na simples inclusão de uma disciplina chamada “Inteligência Artificial” no currículo. A mudança mais profunda está em reconsiderar o que significa administrar uma organização na era dos sistemas inteligentes [7].

A organização do futuro será cada vez mais uma combinação de pessoas, dados, software, automações e agentes de IA. Nesse ambiente, o gestor precisará desenvolver uma nova competência central: orquestrar inteligência distribuída [2][3][4].

Isso significa saber coordenar diferentes formas de inteligência — humana e artificial — para atingir objetivos estratégicos, mantendo responsabilidade, governança, ética e visão sistêmica [4][7][8].

A pós-graduação em Administração, portanto, deverá evoluir de uma formação centrada apenas na gestão de recursos e pessoas para uma formação orientada à gestão de capacidades humanas, digitais e artificiais [1][2][6][7].

Mais do que preparar profissionais para utilizar a Inteligência Artificial, será necessário formar líderes capazes de decidir como, onde, quando e sob quais condições a inteligência artificial deve participar da organização.

Esse talvez seja um dos maiores desafios — e, simultaneamente, uma das maiores oportunidades para profissionais — nas próximas décadas.

Observação: Este artigo foi postado originalmente no LinkedIn

Referências

[1] WORLD ECONOMIC FORUM. The Future of Jobs Report 2025. Geneva: World Economic Forum, 2025.
Acessar o relatório

[2] MICROSOFT. The 2025 Annual Work Trend Index: The Frontier Firm is born. Microsoft, 2025.
Acessar o relatório/artigo

[3] DELOITTE. 2025 Global Human Capital Trends. Deloitte, 2025.
Acessar o relatório

[4] DELOITTE. What’s the Future of Management?. Deloitte, 2025.
Acessar o estudo

[5] MCKINSEY & COMPANY. The State of AI in 2025: Agents, Innovation, and Transformation. McKinsey, 2025.
Acessar o estudo

[6] GMAC — Graduate Management Admission Council. Corporate Recruiters Survey 2025. GMAC, 2025.
Acessar o relatório

[7] AACSB INTERNATIONAL. A Framework for Artificial Intelligence in Business Education. AACSB, 2026.
Acessar o relatório

[8] UNESCO. Guidance for Generative AI in Education and Research. Paris: UNESCO, 2023.
Acessar o guia

Engenharia de Harness: O motor não é mais o problema

Por que a estrutura ao redor do modelo — o “harness” — decide se um agente de IA funciona de verdade

Durante um bom tempo, o jogo foi aprender a se comunicar melhor com o modelo. Depois, o jogo virou garantir que ele tivesse as informações certas na hora certa. Hoje, é preciso ir além.

O que trava um projeto de IA agora é tudo aquilo que cerca o modelo: quem autoriza suas ações, quem audita seus resultados, o que ele consegue reter de uma execução para outra, até onde vai seu raio de ação, e se existe algum registro do que ele fez. Esse conjunto de mecanismos ganhou um nome — “harness”, ou estrutura de execução.

Vale notar que uma etapa não anula a anterior — ela engloba. Saber montar o contexto certo já pressupõe saber formular bem o pedido. E construir um harness robusto pressupõe as duas coisas anteriores, somando ainda um conjunto de capacidades que nem o melhor prompt nem o melhor contexto conseguem entregar sozinhos: gerenciamento de ferramentas, dupla checagem, memória entre sessões, controle de acesso, rastreabilidade, escolha inteligente de modelo e capacidade de aprender com os próprios erros.

Estatísticas recentes mostram que a esmagadora maioria dos projetos corporativos de agentes de IA — quase 9 em cada 10 — não sai do papel rumo à produção. E raramente é porque o modelo escolhido é fraco. O problema costuma estar em outro lugar: informações que se perdem ao longo de sessões longas, ausência de barreiras de segurança, incapacidade de manter estado entre uma interação e outra, ou mecanismos de correção que nunca fecham o ciclo. Coloque duas equipes usando exatamente o mesmo modelo, mas com estruturas de execução diferentes, e os resultados serão completamente distintos. O que separa sucesso de fracasso é essa estrutura — não o modelo em si.

Do que se trata, afinal

Pense no modelo como o cérebro bruto, a capacidade de raciocínio pura. O harness é o que transforma essa capacidade em algo em que se pode confiar na prática. É a ponte entre o raciocínio do modelo e as consequências reais no mundo: como as ferramentas são acionadas, como o trabalho é conferido, o que fica guardado na memória, quem pode fazer o quê, e o registro de tudo isso.

Uma estrutura madura tem, no fundo, sete frentes de trabalho — e cada uma delas resolve um tipo específico de problema.

Conteúdo do artigo

Primeira frente – ferramentas: quem manda nelas

Um princípio central: o modelo jamais deve executar uma ação por conta própria. Ele apenas propõe — indica qual função quer chamar e com quais parâmetros. Cabe à estrutura ao redor validar se o pedido faz sentido, se há permissão para aquilo, executar de fato, e devolver o resultado. Esse intermediário é justamente o que impede que uma tentativa de manipulação maliciosa vire execução de código sem controle.

Na prática, isso funciona como um sistema de rascunho seguido de aprovação. Ações que podem causar dano são propostas, mas ficam retidas até alguém confirmar. Coisas inofensivas, como apenas ler um dado, passam sem barreira nenhuma. Já ações que alteram ou apagam algo esperam luz verde.

Conteúdo do artigo

O ganho real aqui é que o agente nunca fica “no escuro”. Toda tentativa de usar uma ferramenta — tenha ela dado certo, sido barrada por falta de permissão, ou estourado o tempo — volta para o agente como uma resposta organizada. Isso poupa o sistema de ter que adivinhar o que aconteceu lendo uma saída de terminal crua e ambígua.

Segunda frente – loops de verificação: ninguém corrige a própria prova

Um princípio quase óbvio, mas frequentemente ignorado: quem produziu algo não deve ser também quem avalia se ficou bom. Um modelo tende a ser complacente com o próprio trabalho — ele já “acredita” na solução que deu, então uma segunda avaliação, feita por outra instância com instruções diferentes, tende a pegar falhas que passariam batido numa autoavaliação.

Conteúdo do artigo

Um episódio real ilustra bem isso: em certo momento de 2026, o Claude Code apresentou uma queda perceptível de qualidade. Ao investigar, a Anthropic identificou três alterações distintas na camada de estrutura — nada relacionado ao modelo em si: um ajuste que reduziu o esforço de raciocínio permitido, uma falha de cache que descartava parte do histórico de “pensamento” do modelo, e um prompt que restringia demais a verbosidade das respostas. O modelo continuava sendo o mesmo modelo. O que mudou foi tudo em volta dele — e isso bastou para degradar a experiência inteira. A empresa publicou uma análise pública do ocorrido. A conclusão não foi “o modelo precisa melhorar”; foi “a estrutura de execução é, na prática, a qualidade percebida do seu produto”.

Essa checagem independente não precisa ser cara. Coisas simples — o código compila? os testes passam? a mudança ficou dentro do que foi pedido? — podem ser verificadas por um modelo leve e barato. Guarde o modelo mais caro e poderoso para os casos que exigem julgamento de verdade. O que importa não é o preço do verificador, e sim o fato de ele ser separado de quem produziu o resultado.

Terceira frente – contexto e memória: o que fica na cabeça do agente

A lição da era anterior foi: o que você mostra ao modelo pesa mais do que como você formula a pergunta. O passo seguinte é deixar de depender de um humano acertando manualmente o que entra no contexto toda vez — e passar essa responsabilidade para a própria estrutura.

Um sistema bem construído resume o que já foi feito, descarta resultados de ferramentas que já cumpriram seu papel, e mantém na “mesa de trabalho” apenas o que a etapa atual realmente precisa. Sem essa disciplina, conversas longas acabam lotando a janela de contexto disponível, informação relevante começa a ser empurrada para fora, e a qualidade do raciocínio despenca aos poucos.

Conteúdo do artigo

A memória segue a mesma lógica, só que entre sessões diferentes, não dentro da mesma conversa. Regras, restrições e lições aprendidas ficam gravadas em arquivos que são recarregados automaticamente sempre que uma nova sessão começa. Assim, um erro cometido numa sessão anterior não se repete na próxima — porque a lição já está escrita em algum lugar que o sistema sempre consulta antes de agir. Sem esse hábito, cada sessão nasce do zero, sem aprender nada do passado. Com ele, o sistema realmente evolui ao longo do tempo.

Um teste simples para saber se isso está funcionando: se, quarenta interações depois, o agente ainda respeita uma restrição definida logo no início, a memória está fazendo seu trabalho. Se ela evapora bem antes disso, não está.

Quarta frente – Proteções (guardrails): as barreiras de proteção

Antes de qualquer resposta chegar ao usuário final ou a outro sistema, ela deveria passar por uma checagem contra regras estabelecidas. Isso deixou de ser um “extra” — regulamentações recentes (leis estaduais e regionais sobre IA, exigências de conformidade que já pedem prova de controles ativos sobre o que sistemas de IA produzem) tornaram isso praticamente obrigatório.

Um erro comum é tratar todo tipo de agente com o mesmo nível de rigor. Um assistente que só conversa com clientes não precisa das mesmas travas que um agente com poder de alterar um banco de dados de produção. O nível de exigência deveria acompanhar o risco real da tarefa — nem de menos, nem exageradamente mais.

Dá para pensar nessas travas em quatro grandes grupos: as que cuidam do tom e da segurança do conteúdo gerado; as que impedem vazamento de dados sensíveis ou informação pessoal identificável; as que controlam o que o agente pode ou não executar, principalmente ações irreversíveis; e as que limitam gasto — tempo, tentativas, custo em tokens — para que uma tarefa que deveria custar centavos não vire uma fatura de centenas de dólares por causa de um loop mal controlado.

Quinta frente – observabilidade: enxergar o que está acontecendo

Um agente que funcionava perfeitamente semana passada pode começar a falhar essa semana sem que uma única linha de código tenha mudado — o provedor do modelo pode ter feito um ajuste silencioso, uma API externa pode ter mudado o formato da resposta, ou simplesmente surgiu um caso de uso que nunca tinha sido testado. Sem visibilidade sobre o comportamento do sistema, você só descobre o problema quando ele já quebrou algo em produção. Com essa visibilidade, dá para perceber o desvio antes que vire dano de fato.

Times que conseguem acompanhar cada ação tomada por um agente, e identificar quando o comportamento começa a fugir do padrão, são os que conseguem dar mais autonomia ao sistema com segurança, aos poucos. Sem esse acompanhamento, cada nova liberdade concedida ao agente é um tiro no escuro; com ele, vira uma decisão baseada em dados reais.

Vale registrar cada chamada de ferramenta e seu desfecho — isso cria uma trilha auditável do que aconteceu. Vale medir não o volume total gasto, mas o custo por resultado realmente aproveitado — se a maioria do que o agente produz acaba sendo descartada, algo está desequilibrado. E vale comparar o padrão de comportamento de uma semana com o da anterior, para pegar uma eventual regressão antes que o usuário final perceba.

Sexta frente – roteamento e seleção de modelo: nem tudo precisa da artilharia pesada

Nem toda subtarefa exige o modelo mais potente disponível. Verificar formatação ou classificar um item não pede o mesmo poder de raciocínio que planejar uma mudança arquitetural complexa. Um sistema sem essa distinção manda tudo pelo modelo mais caro e reza para o orçamento aguentar. Um sistema bem desenhado escolhe, para cada etapa, o modelo mais econômico capaz de resolver aquilo — reservando o modelo topo de linha só para onde ele realmente faz diferença.

Conteúdo do artigo

A régua prática é simples: tarefas mecânicas e repetitivas vão para modelos rápidos e baratos; tarefas que exigem julgamento, planejamento ou raciocínio mais sofisticado vão para os modelos mais robustos. E essa escolha deve acontecer automaticamente, de acordo com o tipo de tarefa — sem depender de alguém lembrar de trocar manualmente o modelo no meio do processo.

Sétima frente – feedback e autoaperfeiçoamento: aprender com os próprios tropeços

Um sistema estático se comporta do mesmo jeito na centésima execução e na primeira. Um sistema que incorpora feedback, por outro lado, registra cada rejeição, cada estouro de tempo ou orçamento, e transforma isso em uma regra escrita — regra essa que toda execução futura vai consultar automaticamente.

Conteúdo do artigo

Isso não tem nada a ver com retreinar o modelo; os parâmetros internos dele permanecem intocados. O que muda é o ambiente ao redor: as regras ficam mais precisas, a escolha de modelo melhora, o contexto fica mais enxuto e relevante. Com o tempo, a etapa de verificação vai encontrando cada vez menos problemas, simplesmente porque as restrições acumuladas já impedem que os erros antigos se repitam.

Por que a maioria dos projetos não decola

Esse número alto de projetos que travam antes da produção não vem de modelos incapazes — vem de lacunas estruturais: etapas puladas, verificações ignoradas, desvios de comportamento que ninguém está monitorando. Alguns padrões se repetem:

Sessões longas acabam “esquecendo” restrições definidas no começo, porque o processo de resumir o histórico descarta instruções importantes ao longo do caminho — e o agente acaba fazendo exatamente aquilo que tinha sido proibido de fazer.

Quando não existe uma segunda checagem independente, o próprio agente valida seu trabalho — e tende a aprovar quase tudo que produz. Uma avaliação externa, feita por outra instância com critérios diferentes, revela uma fatia significativa de problemas que passariam despercebidos numa autoavaliação.

Sem controle de permissões por ferramenta, uma tentativa de manipulação externa — por exemplo, embutida no texto de uma tarefa ou ticket — pode virar execução de comando sem que nada a impeça no caminho.

Atualizações silenciosas feitas pelo provedor do modelo podem mudar sutilmente o comportamento do sistema, e sem uma referência de comportamento “normal” para comparar, isso pode passar batido por semanas.

A ausência de qualquer persistência entre sessões faz com que o mesmo contexto precise ser reconstruído do zero repetidamente, a um custo real — e os mesmos erros voltam a acontecer porque nada foi de fato aprendido.

E, sem limites claros de gasto, um agente preso num ciclo de tentativas repetidas pode gerar uma conta bem mais alta do que qualquer um esperava.

Em todos esses casos, o modelo em si não é o vilão. Troque-o por outro e o mesmo tipo de falha volta a acontecer. Ajuste a estrutura ao redor, e o mesmo modelo passa a funcionar bem. O momento ideal para pensar nessa estrutura é antes de qualquer usuário real interagir com o agente — não depois que o primeiro problema já causou estrago.

Os limites dessa abordagem

Uma estrutura de execução bem feita não conserta um objetivo mal definido. Se a tarefa em si é vaga, o sistema mais sofisticado do mundo vai simplesmente errar com muita consistência.

As travas de segurança também precisam de manutenção — permissões configuradas uma vez e nunca revisadas dão uma falsa sensação de controle; vale revisá-las periodicamente.

E existe o risco oposto: exagerar na quantidade de camadas de aprovação e verificação torna tudo lento e burocrático. Um sistema pensado para o setor financeiro, aplicado sem ajuste a um projeto pequeno e experimental, vai parecer desnecessariamente pesado. O nível de controle deveria ser proporcional ao risco real envolvido.

No fim das contas, essa estrutura é infraestrutura — não é o produto em si. Ninguém valoriza a estrutura de execução por ela mesma; o que importa é o resultado que o agente entrega através dela.

Para fechar

Se antes o desafio era formular bem uma pergunta, e depois passou a ser escolher bem o que mostrar ao modelo, agora o desafio é montar tudo o que cerca esse modelo para que ele possa operar de verdade em produção: quem autoriza suas ações, quem confere seu trabalho, o que ele carrega de uma sessão para outra, até onde ele pode ir, e se existe registro do que foi feito.

Continuar escolhendo qual modelo usar como se isso ainda fosse a decisão mais importante é responder a uma pergunta que já ficou para trás. O modelo é só o motor; a estrutura ao redor é o veículo inteiro. Não faz sentido entregar um motor sem nada em volta dele.

Não é preciso implementar tudo de uma vez. Comece pelo controle de ferramentas e por uma checagem básica de qualidade. Adicione memória quando perceber que as mesmas situações estão se repetindo entre sessões. Adicione travas de segurança quando o agente passar a interagir com algo visível ao cliente final. Adicione monitoramento quando precisar comprovar que o sistema está funcionando como esperado. Adicione escolha inteligente de modelo quando o custo começar a incomodar. E adicione a capacidade de aprender com os próprios erros quando quiser que o sistema realmente pare de tropeçar na mesma pedra.

São sete frentes de trabalho ao todo. Ignore a maioria delas e você tem, na melhor das hipóteses, uma demonstração interessante. Trabalhe nas sete, e você tem um sistema que efetivamente melhora a cada execução.

Fonte: Adaptado e resumido de: Harness Engineering: the skill that replaced prompt engineering in 2026 e publicado no LinkedIn

Indo mais a fundo: Agent Harness Engineering, by Addy Osman

As tais “Engenharias” do mundo de Agentes que se utilizam da IA Generativa

Conteúdo do artigo

Engenharia de Prompt: mensagem/comando que informa o papel, o contexto, as instruções, alguns exemplos e o formato de saída.

Engenharia de Contexto: é a memória. Trata de como armazenar e recuperar informações relevantes ao Agente de IA.

Engenharia de Harness: É a máquina. Trata de tudo que envolve o cérebro do Agente (Modelo): Contexto, ferramentas, subagentes, RAG, integrações (via APIs ou MSPs), tratamento de erros, …

Engenharia de Loop: é a execução iterativa. Um mecanismo que decide se a máquina deve ser executada novamente. Para isso é necessário um objetivo definido no princípio, limites como um número máximo de iterações ou um orçamento de custo, e um critério automático que determine quando a tarefa realmente terminou. Vide Engenharia de Loop: Como Construir Agentes que Melhoram o Próprio Trabalho

Engenharia de Graph: é a coordenação. Quando vários loops têm que trabalhar juntos, é necessário definir o que se executa, quando se executa, o que pode ser feito em paralelo e quais componentes supervisionam os outros.

Em resumo: Prompt e Contexto estão na fase de coleta do harness; Harness executa um ciclo completo; Loop decide se o ciclo deve ser repetido; Graph decide quais loops executar e como eles se coordenam.

Veja também:

Engenharia de Loop: Como Construir Agentes que Melhoram o Próprio Trabalho

Da criação manual de prompts à engenharia de loop

A maioria das pessoas ainda opera agentes de IA manualmente.

Elas inserem uma tarefa, aguardam uma resposta, revisam o resultado, corrigem os erros, e então enviam outro prompt.

O ser humano ainda é quem executa o loop.

A próxima etapa é diferente.

Você deixa de fazer o prompting do agente passo a passo e passa a construir um loop ao redor dele.

O loop fornece as instruções, verifica o resultado, escolhe a próxima ação e continua executando até que o resultado atenda ao padrão estabelecido.

Isso é engenharia de loop.

A ideia é simples:

Pare de gastar seu tempo criando prompts manualmente para os agentes.

Comece a projetar sistemas que criem esses prompts para você.

“Você não deveria mais ficar criando prompts para agentes de programação. Você deveria projetar loops que criem prompts para seus agentes.”

Boris Cherny lidera o Claude Code na Anthropic.

Ele descreveu essa mesma mudança a partir de seu próprio fluxo de trabalho:

“Eu não crio mais prompts para o Claude. Tenho loops que executam prompts para o Claude e descobrem o que fazer. Meu trabalho é escrever loops.”

Por que a maioria das pessoas ainda não constrói loops de verdade

Os loops parecem incríveis até você ver a conta de tokens.

Um loop de agente normal pode consumir contexto extremamente rápido:

  • Um loop de programação de tamanho médio pode usar 50 mil a 200 mil tokens.
  • Uma frota com um orquestrador e agentes especialistas pode usar 500 mil a 2 milhões de tokens.
  • Um loop programado para ser executado diariamente pode consumir milhões de tokens por semana.

Cada nova tentativa custa tokens. Cada correção custa tokens. Cada etapa de verificação custa tokens. Cada subagente acrescenta uma nova cobrança.

Essa é a limitação oculta que raramente é discutida.

A engenharia de loop não é difícil porque o conceito seja complicado de entender.

Ela é difícil porque a maioria dos usuários não pode pagar por execuções ilimitadas de agentes.

A resposta óbvia é:

“É fácil para você dizer isso, você tem acesso ilimitado à OpenAI.”

E essa crítica é justa.

É por isso que modelos baratos com grandes janelas de contexto são tão importantes.

Para executar loops úteis todos os dias, você precisa de:

  • Tokens de entrada acessíveis
  • Tokens de saída acessíveis
  • Grandes janelas de contexto
  • Chamadas de ferramentas confiáveis
  • Saída estruturada em JSON
  • Alta concorrência
  • Contexto suficiente para lembrar das etapas anteriores

Sem essas características, os loops continuam sendo experimentos caros.

Com elas, os loops se tornam sistemas práticos capazes de executar trabalho real.

O fluxo de trabalho antigo versus o novo

Nos últimos dois anos, a maioria das pessoas utilizou agentes desta forma:

Você cria um prompt. O agente responde. Você revisa a resposta. Percebe um problema. Cria outro prompt.

Funciona, mas não escala.

O fluxo de trabalho antigo

  • Você escreve o prompt
  • O agente cria uma saída
  • Você inspeciona a saída
  • Você corrige os pontos fracos
  • Você repete manualmente o processo

O novo fluxo de trabalho

  • Você define o resultado desejado
  • O loop descobre o que é necessário
  • O loop cria um plano
  • O agente executa o trabalho
  • Um verificador avalia o resultado
  • O loop corrige as falhas
  • O sistema para quando o objetivo é concluído

Um prompt fornece ao agente uma única instrução.

Um loop fornece ao agente um trabalho completo.

O que realmente significa engenharia de loop

Engenharia de loop significa construir ciclos de feedback repetíveis ao redor de agentes de IA.

O objetivo é simples:

Passar de uma primeira tentativa para um resultado verificado, sem que um ser humano controle cada etapa.

O loop básico contém cinco etapas:

  1. Descobrir
  2. Planejar
  3. Executar
  4. Verificar
  5. Iterar

Se o resultado passar pela verificação, entregue-o.

Se o resultado falhar, devolva-o ao loop.

Esse é todo o conceito.

Você não está tentando escrever um prompt perfeito.

Você está criando um sistema que melhora resultados imperfeitos até que eles atendam ao requisito.

Loop de agente único

Os loop geralmente aparecem em dois tamanhos.

A versão menor usa um único agente para completar todo o ciclo.

Ele descobre o que precisa acontecer, planeja o trabalho, executa a tarefa, revisa o resultado e tenta novamente quando algo falha.

É semelhante a uma pessoa editando seu próprio rascunho até que ele esteja pronto.

Loop de agente único funcionam bem para:

  • Tarefas específicas
  • Escopos limitados
  • Objetivos claros
  • Rascunhos de conteúdo
  • Correções de bugs
  • Resumos de pesquisas

Um agente. Um ciclo de feedback. Melhoria contínua por conta própria.

Loop em frota

Um loop em frota opera em uma escala maior.

Um orquestrador recebe o objetivo principal.

Ele divide o objetivo em partes menores.

Essas partes são atribuídas a agentes especialistas.

Cada especialista também pode delegar tarefas específicas a subagentes menores.

Exemplo

Objetivo: Construir um aplicativo de produtividade

 Orquestrador
                  /    |    \
                 /     |     \
          Pesquisa  Engenharia   QA
          Especialista Especialista Especialista
              |          |           |
        Pesquisador   Escritor de   Escritor de
          Web           Código        Testes
                           +            +
                        Debugger    Rastreador
                                      de Bugs 

Isso já não é mais um único agente trabalhando sozinho.

É mais parecido com uma pequena equipe autônoma executando um projeto do início ao fim.

Loops abertos versus loops fechados

Essa é a diferença prática mais importante.

Nem todo loop funciona da mesma maneira.

Loops abertos

Loops abertos são exploratórios.

Você fornece um objetivo amplo e permite que o agente descubra seu próprio caminho.

O agente pode descobrir coisas úteis que você nunca especificou.

Mas também pode se tornar caro e caótico.

Loops abertos podem:

  • Explorar direções demais
  • Desperdiçar grandes quantidades de tokens
  • Gerar trabalho de baixa qualidade em alta velocidade
  • Se afastar do objetivo real
  • Tornar-se difíceis de controlar

Loops abertos são empolgantes.

Mas geralmente não são o melhor ponto de partida.

Loops fechados

Loops fechados possuem limites claros.

O ser humano define o caminho primeiro.

O loop ainda opera de forma independente, mas permanece dentro de regras explícitas.

Um loop fechado inclui:

  • Um objetivo claro
  • Etapas definidas
  • Avaliação após cada etapa
  • Uma condição de parada
  • Transferência para um ser humano caso o sistema fique bloqueado

Essa é a versão que gera valor hoje.

Ela custa menos. É mais fácil de confiar. Produz resultados mais consistentes.

Comece com loops fechados.

Torne-os mais abertos somente depois que seus mecanismos de verificação forem suficientemente robustos.

Os 6 blocos de construção de um loop eficaz

Todo loop segue conceitualmente o mesmo ciclo de cinco etapas.

Na prática, seis blocos de construção tornam esse ciclo realmente útil.

1. Automações

A automação é o coração do loop.

Ela inicia o processo sem exigir que você se lembre de iniciá-lo manualmente.

Exemplos:

  • Executar todas as manhãs
  • Executar sempre que um PR for aberto
  • Executar depois que um arquivo for alterado
  • Executar quando um novo ticket aparecer
  • Continuar até que todos os testes sejam aprovados

Se você ainda precisa iniciar cada ação manualmente, o loop não está fazendo o suficiente.

2. Worktrees

Worktrees tornam-se importantes quando vários agentes editam código simultaneamente.

Sem isolamento, os agentes entram em conflito.

Dois agentes podem alterar o mesmo arquivo.

Um agente pode sobrescrever o trabalho de outro.

Um worktree fornece a cada agente um espaço de trabalho e uma branch separados.

Isso permite que vários agentes trabalhem em paralelo sem transformar o repositório em uma bagunça.

3. Skills

Skills armazenam conhecimento reutilizável sobre o projeto.

Pare de explicar o mesmo contexto a cada execução.

Escreva as informações importantes uma única vez.

Permita que todos os loops futuros as reutilizem.

Arquivos de skills úteis podem conter:

  • Visão do produto
  • Arquitetura
  • Regras do projeto
  • Instruções de compilação
  • Instruções de testes
  • Ações que o agente nunca deve executar

Sem skills, cada loop começa do zero.

Com skills, cada execução começa com o conhecimento acumulado dos trabalhos anteriores.

4. Plugins e conectores

Um loop que só consegue ler arquivos locais tem valor limitado.

Conectores permitem que ele interaja com as ferramentas onde o trabalho real acontece.

Exemplos:

  • GitHub
  • Slack
  • Linear
  • Jira
  • Gmail
  • Google Drive
  • Bancos de dados
  • APIs de staging

Essa é a diferença entre:

“Aqui está uma possível correção.”

e:

“Abri o PR e o conectei ao ticket. Depois monitorei o CI e publiquei a atualização final.”

5. Subagentes

O agente que cria e o agente que verifica nem sempre devem ser o mesmo.

Um agente que escreveu o código pode ser tolerante demais ao revisá-lo.

Um agente que escreveu um artigo pode deixar passar as mesmas seções fracas duas vezes.

Use agentes separados para:

  • Exploração
  • Implementação
  • Revisão
  • Testes
  • Verificação de fatos
  • Resumos finais

A qualidade melhora quando o revisor é independente.

O criador não deve ser o único responsável por verificar o trabalho.

6. Memória

A memória permite que o loop continue entre várias execuções.

O modelo esquece.

O repositório não.

As anotações não.

O registro do projeto não.

A memória pode ser armazenada em:

  • Arquivos Markdown
  • Logs do projeto
  • Tickets do Linear
  • Issues do GitHub
  • Cofres do Obsidian
  • Bancos de dados
  • Claude Projects

Um loop de longa duração precisa lembrar o que já foi tentado.

O que funcionou.

O que falhou.

E o que ainda precisa ser concluído.

Sem memória persistente, o loop começa do zero toda vez.

Exemplos reais de loops

Esses fluxos de trabalho tornam a ideia mais concreta.

Loop de programação

Ler VISION.md + ARCHITECTURE.md
↓
Planejar a próxima alteração
↓
Editar o código
↓
Executar os testes
↓
Se os testes falharem → inspecionar o erro
→ corrigir
→ testar novamente
↓
Se os testes passarem → resumir as alterações
↓
Parar

Um ser humano não precisa conduzir cada etapa.

O agente escreve, testa, corrige e verifica seu próprio trabalho.

Loop de pesquisa

Definir a pergunta de pesquisa
↓
Encontrar fontes relevantes
↓
Resumir as evidências
↓
Verificar cada afirmação em relação às fontes
↓
Comparar informações conflitantes
↓
Criar a síntese final
↓
Parar quando o limite de confiança for atingido

Isso produz um resultado muito mais robusto do que pedir um único resumo rápido.

Loop de conteúdo

Definir tópico + público + objetivo
↓
Criar o primeiro rascunho
↓
Enviar para um agente de crítica
↓
Reescrever usando a crítica
↓
Avaliar segundo os critérios de sucesso
↓
Se passar → publicar
↓
Se falhar → reescrever novamente

O loop transforma uma única ideia em um sistema de conteúdo repetível.

Loop de prospecção de vendas

Definir o ICP
↓
Encontrar leads que correspondam ao perfil
↓
Enriquecer cada lead com dados da empresa
↓
Qualificá-los de acordo com os critérios
↓
Personalizar a mensagem
↓
Executar uma revisão de qualidade
↓
Enviar ou encaminhar para um ser humano

Todos os exemplos utilizam a mesma estrutura:

Objetivo → Ação → Verificação → Correção → Repetição até concluir o trabalho

Engenheiro de prompt versus engenheiro de loop

Essa é a nova lacuna de habilidades que está surgindo em 2026.

Engenheiro de prompt

Um engenheiro de prompt concentra-se em criar instruções melhores.

Ele aprimora a redação.

Produz uma resposta única mais forte.

Mas, depois que o agente termina, um ser humano ainda precisa revisar tudo.

O ser humano continua sendo o loop de feedback.

Engenheiro de loop

Um engenheiro de loop constrói o próprio sistema de feedback.

Ele determina:

  • O que inicia o loop
  • Qual contexto o agente recebe
  • Quais ferramentas ele pode acessar
  • O que é considerado sucesso
  • Quem verifica o resultado
  • Quando o processo deve parar
  • Onde o resultado final é armazenado

Um engenheiro de prompt diz:

“Escreva uma função para mim.”

Um engenheiro de loop diz:

“Escreva a função.” “Teste-a e corrija-a até que todos os testes sejam aprovados.” “Depois, faça um resumo da alteração.”

As ferramentas podem ser idênticas.

A mentalidade é completamente diferente.

Os construtores de IA que geram maior impacto estão indo além de instruções melhores.

Eles estão criando sistemas que descobrem e planejam, executam e verificam, e então param no momento correto.

A versão resumida

Engenharia de loop é a transição de prompts manuais para ciclos automatizados de feedback.

A mudança

  • Forma antiga: Dar ao agente uma tarefa de cada vez
  • Nova forma: Construir um loop que gerencia o ciclo completo

As 6 coisas que você constrói

  • Automações: Iniciam o loop automaticamente
  • Worktrees: Permitem que os agentes trabalhem em paralelo sem conflitos de arquivos
  • Skills: Reutilizam o conhecimento do projeto em cada execução
  • Plugins e conectores: Dão ao loop acesso a ferramentas reais
  • Subagentes: Separam criadores de revisores
  • Memória: Preserva o conhecimento entre as execuções

Os 2 tamanhos

  • Loop de agente único: Um agente melhora repetidamente seu próprio trabalho
  • Loop em frota: Um orquestrador coordena especialistas e subagentes

Os 2 tipos

  • Loop aberto: Flexível, exploratório e caro
  • Loop fechado: Limitado, confiável e acessível

As 5 etapas

  1. Descobrir
  2. Planejar
  3. Executar
  4. Verificar
  5. Iterar

O verdadeiro problema de custo

  • Loops consomem tokens rapidamente
  • Modelos baratos com contexto longo tornam os loops viáveis
  • Sem tokens acessíveis, a maioria dos usuários nunca passa dos experimentos

A mudança de mentalidade

  • Engenheiros de prompts solicitam resultados à IA
  • Engenheiros de loop constroem sistemas que entregam resultados verificados

Esse é o verdadeiro ponto de virada.

Pare de procurar um único prompt perfeito.

Construa um loop que continue tornando melhores os resultados imperfeitos.

Um loop confiável vencerá um prompt perfeito.

Fonte:

Este artigo e a imagem foram traduzidos e adptados do texto original em inglês de @elune0x em https://x.com/elune0x/status/2079923329633313196 e publicado no Linkedin

Vide: